DAU 跌了 50 万,Delta 法一算就知道哪个渠道贡献大。但如果是留存率跌了 2 个百分点呢?分母(昨日用户数)和分子(今日回访用户数)同时在动,每个渠道的量也在动——直接做差,会把"量变了"和"率变了"搅在一起,算出一笔糊涂账。除法指标的归因,必须先解决这个结构性难题。
一、除法指标为什么不能直接做差
除法指标一般需要通过两个累加型指标相除得到。以全渠道留存率为例:
分子分母都是加法指标,但商不是。整体留存率的波动可能来自三种力量的叠加:
- 各渠道自身的留存率变了(质量效应);
- 各渠道的用户占比变了(结构效应)——低留存渠道放量,大盘留存自然被拉低;
- 两者交叉:占比和留存同时变化。
Delta 法只看差值,无法把这三股力量拆开。这就是剔除法和加权分解要解决的问题。
二、除法指标归因方法 1:剔除法
2.1 原理
把基线期和本期某个维度值的数据同时剔除掉,然后计算此时总体值的变化率——变化率越小,说明该元素对波动的贡献越大。
逻辑是反证式的:如果剔除渠道 A 后,大盘的异动基本消失(前后变化率很小),说明异动的"质量"就藏在渠道 A 里;如果剔除后大盘照样大跌,说明渠道 A 不是主因。
2.2 实例:次留下滑归因
我们来看一个完整案例:
- 发现某产品从 4 月 10 日之后次留数据开始下滑;
- 拆分不同渠道看留存走势,发现异常渠道 A 的走势与大盘走势类似(同样在 4 月 10 日后下滑);
- 剔除渠道 A 后重新计算:4 月 10 日之后的次留数据与 4 月 10 日之前的变化率很小——渠道 A 的留存下跌就是根因。
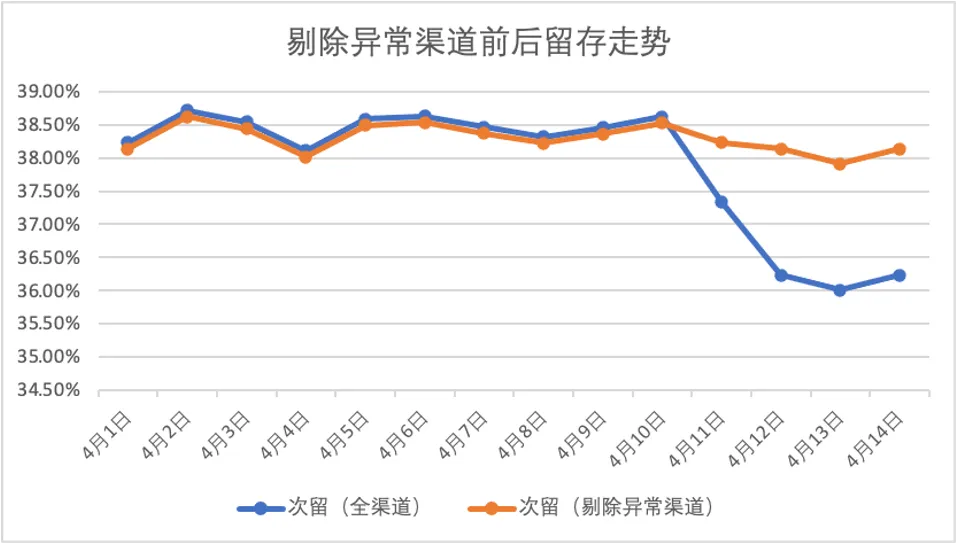
第 2 步值得注意:渠道 A 与大盘走势"类似"只是初步嫌疑,真正定罪的是第 3 步的反事实检验——去掉它,大盘就稳了。
2.3 局限
- 一次只能验证一个嫌疑对象:渠道多时要反复剔除,效率低,且无法输出量化的贡献度排序;
- 剔除改变了分母:去掉一个大渠道后,剩余渠道的权重被放大,小渠道的波动会被动显得更显眼,结论要谨慎复核;
- 对结构效应无能为力:如果大盘留存跌是因为低留存渠道放量(每个渠道自身留存都没变),剔除任何单一渠道都解释不了。
第三点正是加权分解法的切入点。
三、除法指标归因方法 2:转化成加法指标
3.1 原理:加权分解
除法指标虽然不能像加法指标那样直接用差值计算,但可以转化为加法型来度量贡献值。全渠道留存率可以改写成加权平均:
即:大盘留存 = 渠道占比 × 渠道留存 的求和(PPT 图示中"渠道2占比 × 渠道2留存"的加和)。于是整体变化可以拆成每个渠道的两部分贡献:
其中交叉项 \Delta w_i \cdot \Delta r_i 按惯例均分或按权重分摊进两项(与 LMDI、Shapley 值处理交互项的思路一致)。单个渠道对大盘留存的贡献度为:
这样每个渠道的贡献被拆成两笔账:占比动了多少,留存动了多少——"渠道 2 贡献了大盘留存的 -80%,其中 -60% 来自它自身留存下滑,-20% 来自它占比上升"这样可行动的结论就出来了。
3.2 与统计学的接轨
这个"加权平均的变化拆解"在统计学里有成熟对应:流行病学的标准化率(direct standardization)用标准人口结构消除构成比差异后再比较率,本质就是控制 w_i、只比较 r_i;经济学中的**结构分解分析(SDA)**则把产出变化拆为技术效应与结构效应,与本节公式同构。做除法指标归因时,永远记住两条线分开看:结构在动,还是质量在动。
四、辛普森悖论:分组全涨,大盘在跌
讲完方法,看一个足以让所有朴素归因翻车的案例。
4.1 现象
辛普森悖论:同一组数据,整体的趋势和分组后的趋势完全不同。
某小说应用,为了简化场景,假设充值用户无广告收入、广告用户无充值收入,人均收入数据如下:
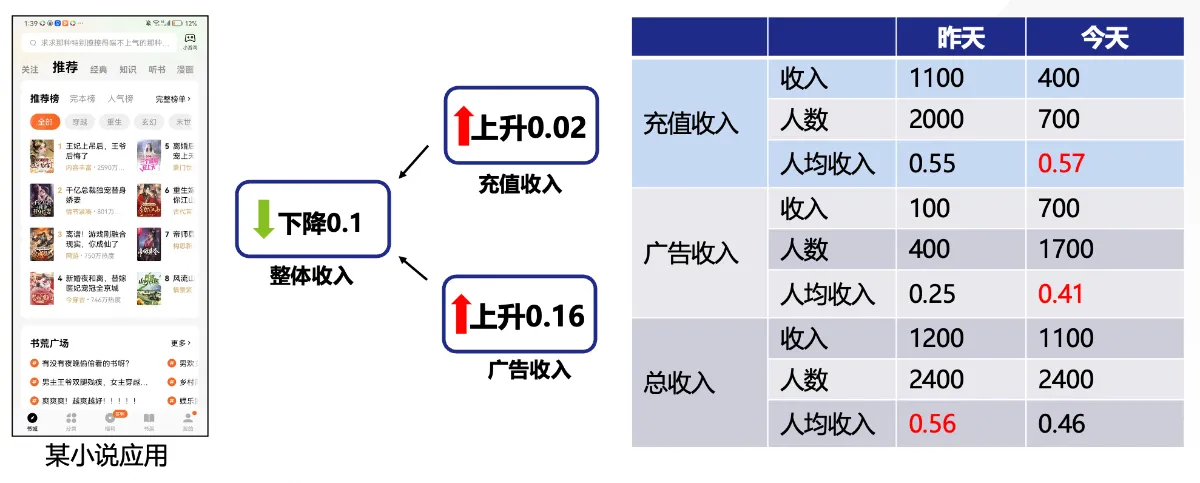
复算验证:充值用户人均 1100/2000 = 0.55 → 400/700 ≈ 0.57,在涨;广告用户人均 100/400 = 0.25 → 700/1700 ≈ 0.41,也在涨;总人数不变(2400),整体人均却从 0.56 跌到 0.46。两类用户的人均收入都在上升,整体人均收入反而下降了 0.1。
4.2 机制:结构迁移吞掉了质量提升
用第三节的加权分解一看就透。整体人均收入 = 充值用户占比 × 充值人均 + 广告用户占比 × 广告人均:
- 昨天:2000/2400 × 0.55 + 400/2400 × 0.25 = 0.458 + 0.042 ≈ 0.56
- 今天:700/2400 × 0.57 + 1700/2400 × 0.41 = 0.166 + 0.290 ≈ 0.46
高价值充值用户占比从 83% 缩到 29%,低价值广告用户从 17% 涨到 71%。两群人各自的人均收入提升(质量效应为正),完全敌不过用户结构的剧烈劣化(结构效应为负)。
这正是辛普森悖论的本质:比率指标的"分组趋势"和"整体趋势"之间隔着一层结构权重,结构剧变时两者可以彻底反向。就本例而言,它甚至给出了比"归因"更重要的业务判断:人均收入下跌不是变现能力出了问题,而是产品的高价值用户在流失——该修的是用户结构,不是广告策略。
4.3 对归因工作的三点提醒
- 分组上涨 ≠ 没事。如果只看分渠道报表,两个分组都在改善,很容易误判"大盘下跌是数据错误"。看到分组与整体反向,第一反应应是查结构变化;
- 剔除法在辛普森悖论场景下会失灵。每个分组的率都在改善,剔除谁大盘都好不了——此时只有加权分解能给出正确答案;
- 汇报分组数据时必须同时汇报占比。只报"各渠道留存率均正常"而不报渠道结构变化,是在给决策者埋雷。
辛普森悖论的经典出处是 Blyth (1972) 的正式命名,最著名的案例是 1973 年 UC Berkeley 研究生录取数据:整体看男性录取率显著高于女性,按院系分组后大多数院系反而女性录取率更高——原因是女性更多申请了录取率低的院系。与本文的案例完全同构:结构(申请分布 / 用户构成)才是隐藏的第三变量。
五、小结
- 除法指标分子分母同时在动,直接做差会把结构效应和质量效应搅在一起;
- 剔除法是反证式定位:剔掉嫌疑元素看异动是否消失,简单有效,但一次只能验一个对象、且对结构效应无解;
- **加权分解(转化成加法指标)**是正解:R = \sum_i w_i r_i,把每个元素的贡献拆成"占比变化 + 率变化"两笔账,对应统计学的标准化率与结构分解分析;
- 辛普森悖论是结构效应的极端形态——分组全涨、大盘反跌,它提醒我们:归因不只看率,更要看结构;分组数据正常,不代表大盘正常。
至此,加法指标(Delta、基尼)与除法指标(剔除、加权分解)的归因方法已齐。下一篇讲乘法指标——两边取对数,乘法变加法,同样回到 Delta 的世界。