一次活动产生了一万次分享,究竟算不算成功?如果大部分链接无人打开,或者进入的都是老用户,分享量再高,也不能说明拉新有效。
衡量社交裂变,需要分清三个问题:每位用户带来多少有效新用户,一轮传播需要多久,以及这些新增中有多少真正由活动创造。病毒系数、传播周期和增量评估,分别回答这三个问题。
一、先把K值的分母说清楚
病毒系数K表示:在约定的观察窗口内,一位用户平均带来多少下一代新用户。最直接的统计方式是:
分母必须包含没有分享的人。如果只计算分享者,就应明确叫“每位分享者带来的新用户数”。有效新用户可以定义为注册、激活或首单用户,但比较活动时必须保持同一标准。
为定位损耗,可以进一步拆成:
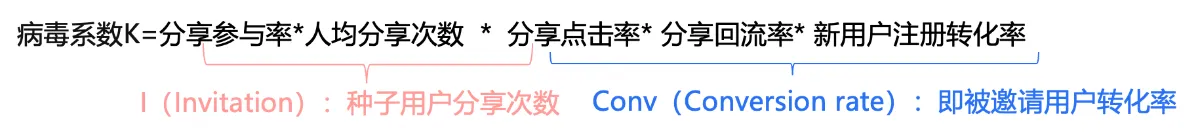
图中把K分为红色的邀请端I和蓝色的转化端Conv:前者回答“平均每位初始用户产生多少次邀请”,后者回答“这些邀请中有多少最终带来新用户”。运营可以据此区分分享不足与承接损耗,而不是只盯着最终注册量。
对应公式,s是分享参与率,i是每位实际分享者的平均邀请数,c是邀请点击率,r是点击后到达目标产品的比例,a是到达后完成有效转化的比例。图中“人均分享次数”必须按实际分享者计算,I=s×i才是摊到全部初始用户的平均邀请数。如果业务统计的是分享按钮点击次数,还不能直接把它当作邀请人数。各项必须来自同一批用户和相互衔接的事件,不能把不同渠道的平均值随意相乘。
以一组假设数据为例:
| 环节 | 口径与假设 | 结果 |
|---|---|---|
| 初始用户 | 100人中20人分享 | 分享参与率20% |
| 发出邀请 | 每位分享者邀请5人 | 共100次邀请 |
| 好友点击 | 邀请点击率40% | 40次点击 |
| 回流产品 | 点击后的到达率50% | 20次到达 |
| 完成注册 | 到达后的注册率30% | 6名新用户 |
假设没有重复接收者、老用户和异常账号,则K=0.2×5×0.4×0.5×0.3=0.06,即每100位初始用户带来6名注册新用户。每位分享者的贡献则是6÷20=0.3,两者不能混用。
如果“人均邀请数”已经按全部100人计算,数值就是1,不能再乘20%。如果落地网页本身就是目标产品,也不应凭空增加一次“回流率”,重复扣减同一段损耗。
二、用真实事件拆解分享链路
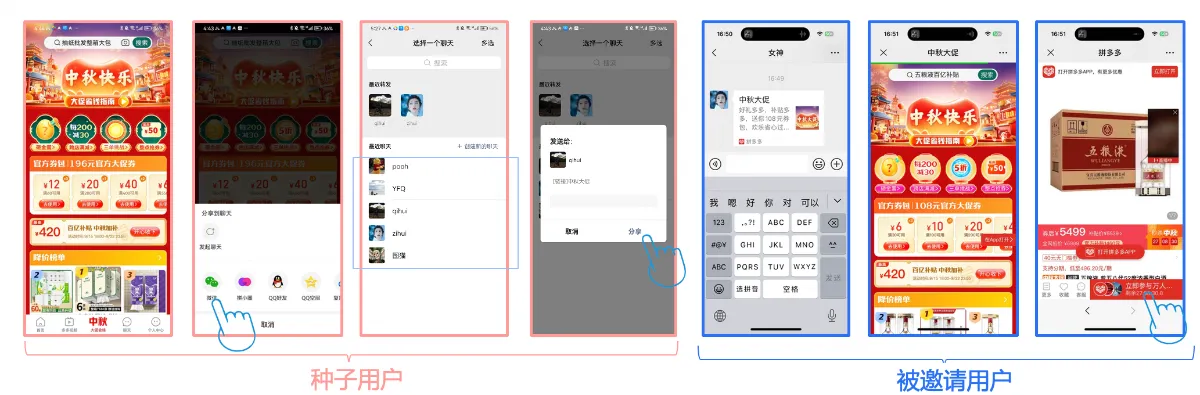
这张流程图用红框标出种子用户的分享过程,用蓝框标出被邀请用户的接收与浏览过程。应沿着两侧的交接点阅读:种子用户完成发送后,接收者是否看到卡片、打开页面并继续操作,仍是独立的转化环节。
**红框侧看分享是否真正完成。**四个界面依次展示活动页、渠道面板、好友选择和发送确认。产品应区分分享入口点击、唤起面板、选择对象与确认发送;用户可能在任一步取消。即使观察到发送动作,也不能据此确认接收者已经阅读,渠道没有返回的状态应保留为未知。
**蓝框侧看承诺如何被承接。**三个界面展示会话卡片、活动落地页和商品页,后两者仍出现打开App的入口。运营应检查卡片、活动与商品信息是否连贯,技术则要分别记录可观测的页面到达、商品访问和App成功唤起。图中展示了回流入口,没有展示成功唤起App、注册或下单,因此不能把“点击打开App”直接算作回流成功,也不能由截图判断转化率。
这条链路说明,分享端与接收端需要分别优化,再通过业务事件连接起来。具体页面只用于分析交互步骤,不代表其优惠规则、跳转方式或历史平台能力可以直接照搬。
实际分析时,可以先看哪里流失,再提出假设:入口点击少,检查分享理由和时机;好友到达少,检查卡片表达、加载及跳转;到达多而激活少,检查价值兑现和操作门槛。某项比例最低,并不意味着它最值得投入,还要比较可改善空间、成本和用户质量。
微信等外部渠道未必允许业务准确观察消息送达或阅读。缺失的数据应标记为未知,可用“每位初始用户带来的可识别访问数”和“访问到有效激活率”辅助诊断,避免用群人数冒充触达人数。
如果同一活动还通过群聊传播,测量口径需要另行处理:一条消息可能被多人看到,同一人也可能在多个群重复接触。不能简单将“发送次数×群人数”代入邀请数;应尽可能按可识别访问者和最终账号去重,无法识别的部分保留测量限制。
三、传播周期决定增长何时发生
K描述一代用户带来多少下一代用户,传播周期CT描述两代用户完成同一关键事件的典型时间间隔。例如,上一代完成激活,到其带来的下一代完成激活,平均需要几天。
在每位用户只计一轮贡献、各代K保持不变、没有重复用户的理想模型中,初始用户为N₀,传播n轮后的累计人数为:
下表是累计人数相对初始人数的倍数,包含初始用户,并非每轮新增人数:
| K | 第1轮 | 第2轮 | 第3轮 | 第4轮 |
|---|---|---|---|---|
| 0.2 | 1.2 | 1.24 | 1.248 | 1.2496 |
| 0.5 | 1.5 | 1.75 | 1.875 | 1.9375 |
| 2 | 3 | 7 | 15 | 31 |
| 5 | 6 | 31 | 156 | 781 |
| 10 | 11 | 111 | 1111 | 11111 |
表中最值得看的是增长形态:K小于1时,每代新增逐渐减少;K等于1时,每代新增相同,累计线性增加;K大于1时,模型中的每代新增扩大。高K行只是数学演示,不是可持续的业务预测。
若CT固定,时间T内完成的轮数可粗略取⌊T/CT⌋。假设K=0.5、初始用户100人,周期7天时,28天完成4轮,累计期望值为193.75人;周期14天时只能完成2轮,为175人。小数表示模型期望,不是实际人数。
缩短周期能让成果更早出现,但不会自动改变K。在上述K=0.5的模型中,即使无限延长时间,累计也只趋近200人。优化应减少加载、重复注册和价值体验的等待,不能用强制分享或频繁催促换取表面速度。
现实中的周期有长有短,用户还会重复邀请、跨圈重叠或停止使用。应按加入批次给予相同观察时长,记录各代K及转化延迟分布,避免将尚未完成传播的新批次与成熟批次直接比较。累计注册也不能代替当前活跃人数。
多阶传播还会改变种子用户的选择。“高节点用户”在这里指能带来较高后续传播价值的候选人,不是一个标准中心性指标,也不等于好友最多的人。
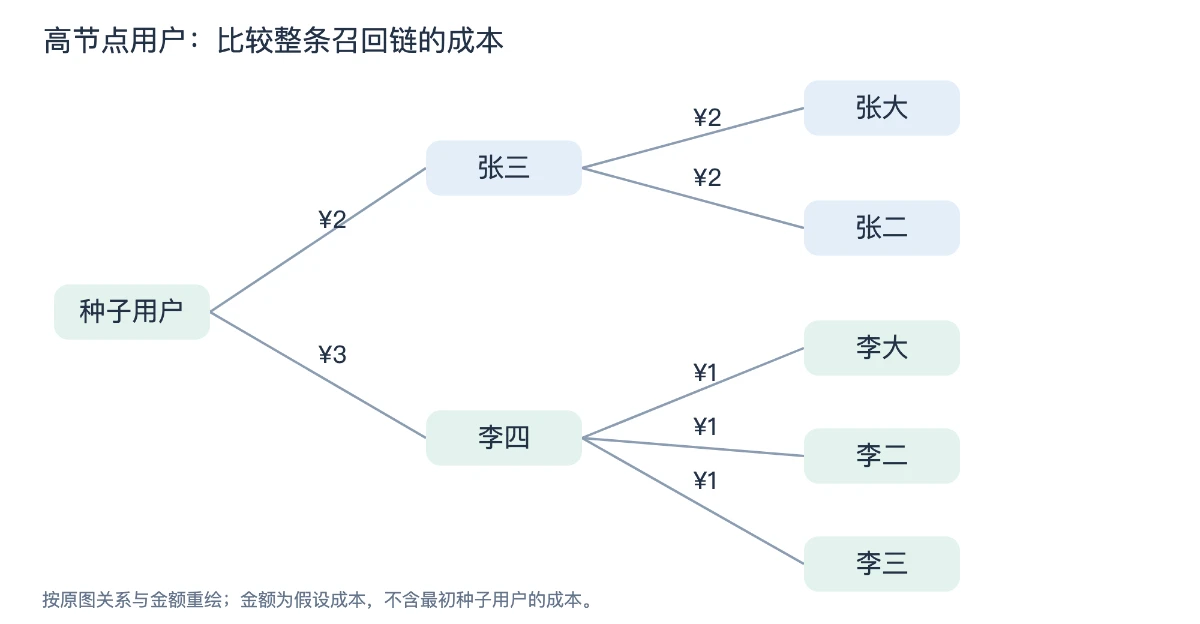
图中种子用户召回张三、李四分别花2元、3元;张三再召回两人,各花2元,李四再召回三人,各花1元。重点是从直接成本转向整条链的成本:只看第一层,张三便宜;假设所有人都成功召回、彼此不重复且价值相同,计入候选人本人,张三链平均成本为(2+2+2)÷3=2元,李四链为(3+1+1+1)÷4=1.5元。图按原关系重绘,展示的是召回算例,不能直接算作新增获客成本,也未计最初种子用户和其他运营成本。
实际排序应估计各层成功概率、去重人数、后续留存与贡献,再扣除激励和履约成本。相同DARPU也不代表相同长期价值。可在小规模对照中验证,不能仅因模型预测高就发放大额奖励;关系重叠与接收者负担也要计入。
若每代病毒系数均为K、无重复且K<1,每位初始用户带来的无限代累计新增期望为K+K²+…=K/(1-K),不含初始用户;有限观察期只累加已观察的轮数。这里用“第几阶”表示传播深度,避免再用K表示阶数。链路贡献属于归因,是否真有增量仍需检验。
四、归因新增还要经过增量检验
一个用户通过邀请链接注册,说明这次注册被归因给社交渠道;没有邀请活动时,他是否仍会注册,则是另一个问题。
可以在条件允许时设置随机对照,提前确定目标行为、观察周期、样本量和去重规则,比较两组的整体有效新增,而不只比较带邀请参数的注册。两组初始规模不同时,应先按同一分母换算。
社交实验还存在相互影响:实验组可能把邀请发给对照组。微软的实验方法与网络实验研究都提醒,简单按个人分组可能产生偏差。可根据关系结构考虑群组随机化,但仍要检查跨组传播、样本量和组间差异,不能以为换一种分组方式就自然准确。
决策至少同时看四项:有效激活或首单增量、相同周期的留存、奖励与履约成本,以及投诉和异常账号。K上升而留存下降,可能只是补贴吸引了低意愿用户;K不足1但增量收益覆盖成本,仍可能是有价值的获客补充。
一份可用于决策的裂变报告,应把用户批次、观察窗口、转化标准、去重规则和测量盲区写在数字旁边。只有先统一这些口径,K值的变化才有可比性,团队也才能判断下一步应改善分享、承接,还是产品本身。