“你可能认识的人”为什么经常配着“10位共同好友”“你的群友”等标签?因为用户决定是否建立联系时,需要一个解释:这个人为什么出现在这里,我们有什么关系?
好友推荐包含三个相连的环节:用关系数据找到候选人,用排序判断推荐顺序,再用邀请文案与标签说明连接的理由。算法和表达应指向同一套真实依据。
一、邀请文案与tag:让用户看懂关系依据
好友推荐里的tag,是“共同好友”“通讯录好友”“群友”等关系标签。它把系统的推荐依据变成用户能理解的线索,帮助用户回答“我为什么要认识这个人”。
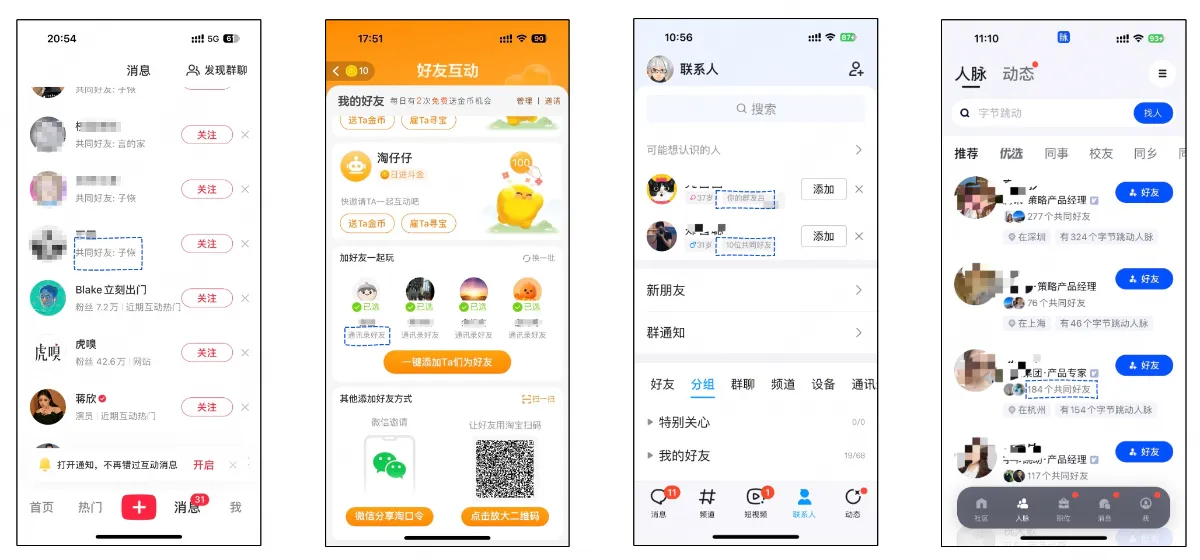
图中从左到右是小红书、淘宝、QQ和脉脉。蓝色虚线框标出了具体共同好友、通讯录好友、群友和共同好友数量。重点看这些标签分别提供了什么证据:有人能串起双方的关系、联系方式存在匹配、共享某个群体,或者关系网络有重合。产品应按真实依据选择表达;这些线索都不能单独证明双方认识或彼此可信。
四种呈现可以归纳成三类设计:
| 标签形式 | 帮助用户判断什么 | 需要注意什么 |
|---|---|---|
| 具体共同好友,如“共同好友:某某” | 能否通过一个熟悉的人认出对方 | 展示姓名和关系前检查可见范围,不能暗示该好友作了担保 |
| 关系来源,如“通讯录好友”“你的群友” | 为什么这个账号与自己有关 | 通讯录匹配不等于双向好友,同群也不等于有过交流 |
| 重合数量,如“10位共同好友” | 双方关系网络的重合程度 | 统一去重与关系口径;人数多不代表关系亲密 |
图中脉脉还展示城市、企业人脉等背景信息,可以补充职业场景。小红书同时推荐热门账号,则说明“可能认识”与“可能感兴趣”可以共存,但两种理由应分别表达。不要把受欢迎程度写成私人关系,也不要把企业人脉数量解释为共同任职经历。
**标签解释来源,邀请文案补充身份和联系目的。**确实参加过同一场活动,可以写:“你好,我是昨天访谈工作坊里提问的林某,想继续交流提纲设计。”仅有共同好友,就不应默认生成“老朋友,好久不见”。文案应允许用户修改,不能替用户认领并不存在的交情。
落地时,优先保留一两条最相关、可核验的依据。图中淘宝的批量添加入口还提醒我们:访问通讯录、匹配账号与发送邀请是不同动作,应让用户看清对象并主动选择;页面显示“已选”本身不能证明授权充分。
二、三元闭包:共同好友提供线索,不保证关系
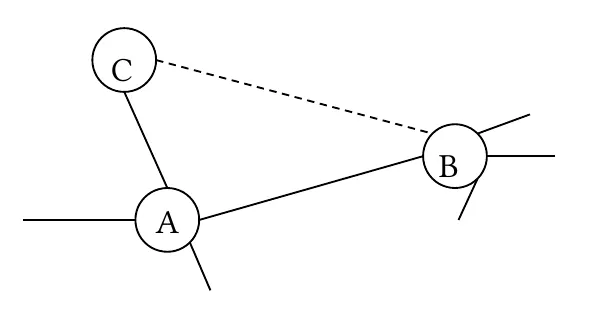
图中A已经与B、C相连,B与C之间用虚线表示待形成的关系。重点是共同联系人提供了接触机会和共同背景。推荐系统可以据此发现候选人,但虚线不表示关系必然出现,也不表示将形成强关系。
三元闭包描述的是:拥有共同邻居的两个人,存在形成连接的倾向。共同活动、相似背景或介绍机会,都可能参与其中。即便在“强三元闭包”这一建模假设中,两条强联系对应的第三条边也可以是弱联系。
常见的两个结构指标需要区分:
- 局部聚集系数:某个用户的好友之间,实际连接数占所有可能连接数的比例。例如4位好友有6种配对,其中3对相连,系数就是0.5。
- 全局传递性:整个网络中,闭合三元组占所有以某个节点为中心的连通三元组的比例,常写作“3×三角形数÷连通三元组数”。它不等于局部聚集系数的简单平均。
这些指标描述网络已有的闭合程度,不能直接当作某对用户明天成为好友的概率。推荐是否促成了新连接,需要结合时间和对照数据判断。
三、PYMK:先确定推荐目标,再选择排序依据
PYMK是People You May Know,即“你可能认识的人”。同样是推荐一个人,产品可能希望帮助用户找回熟人、拓展职业关系,或结识新朋友。目标不同,排序依据与成功标准也应不同。
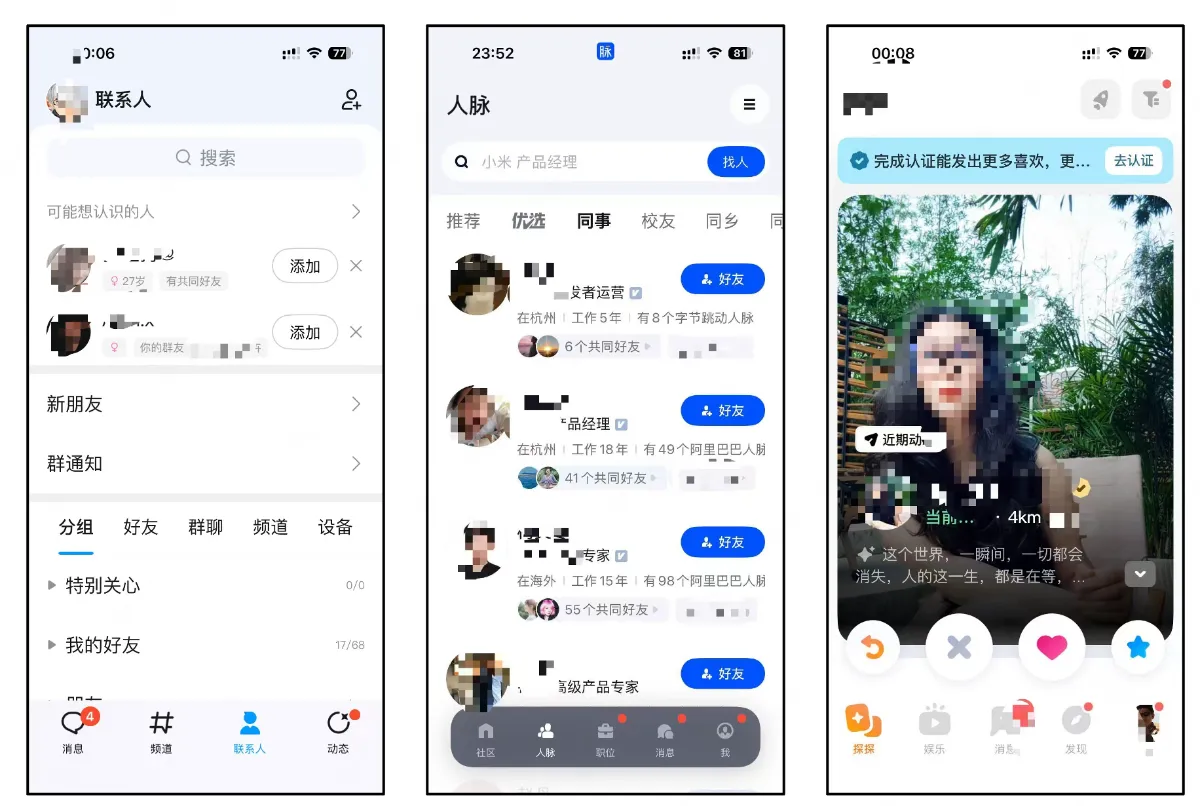
图中从左到右是QQ、脉脉和探探。QQ强调共同好友与群友;脉脉同时呈现职业背景和共同好友;探探突出个人展示、距离以及喜欢或跳过。重点是三类页面分别强调熟人线索、职业联系和新关系发现。产品应据此明确连接目标,不能仅用“添加按钮点击率”衡量全部场景;截图只展示界面,不能据此反推后台特征、权重或效果。
对找回熟人的场景,共同好友数是一个容易解释的基线:
N(u)表示用户u的好友集合,交集大小就是两人的共同好友数。例如两人都与甲、乙相连,共同好友数就是2。计算前应排除本人、已有好友及不可推荐的关系。在单向关注网络里,还须明确统计的是共同关注对象、共同粉丝,还是互相关注,不能混用。
职业关系可以进一步考虑背景重叠。LinkedIn的公开工程资料介绍过:从朋友的朋友发现候选人,再结合学校、组织及任职时间重叠等特征建模。“曾在同一家公司”因此可以细化为“是否在同一时期共事”。这描述的是特定时期的公开方案,并非当前系统的完整实现。
对新关系发现,共同好友少未必是缺点。产品可以在合法取得、符合用户预期的数据范围内,验证兴趣、活动场景等线索;距离近只能说明空间接近,不能证明认识或愿意联系。
实施流程可以归纳为:召回候选 → 过滤不可推荐关系 → 按目标排序 → 展示真实理由。同时检查候选是否被超级连接者主导,以及缺少共同好友的新用户是否仍有合理入口。先把目标与基线讲清楚,再决定是否需要更复杂的模型。
四、加入时间:区分“认识多久”与“最近有多相关”
共同好友数量相同,推荐价值仍可能不同。最近加入一个项目团队,与多年前短暂进入一个大群,提供的关系线索并不一样。
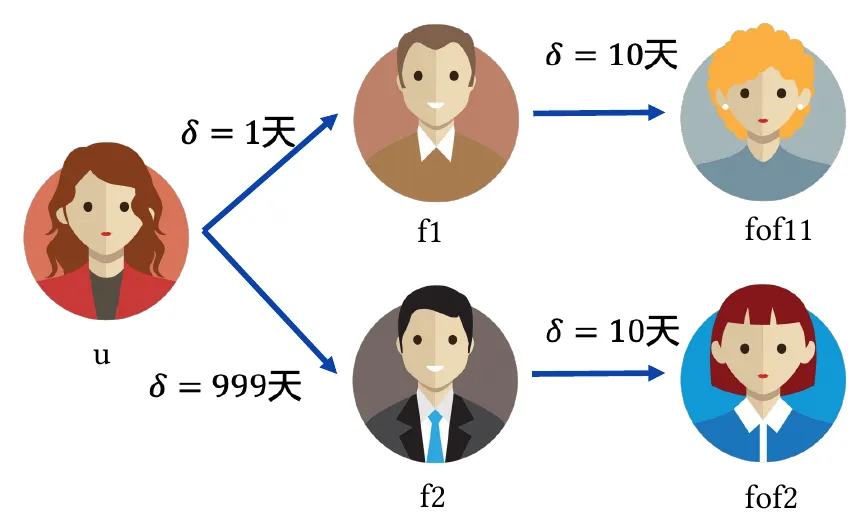
图中u分别通过f1、f2连接到两个候选人:第一段关系为1天和999天,第二段均为10天。重点是相同长度的两跳路径,可以具有不同的新近程度。模型可为路径加权,但“新加的好友更相关”只是待验证假设;多年好友仍可能保持密切互动。箭头表示推荐路径,不必然表示单向好友关系。
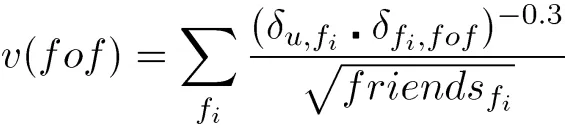
图中公式把每条路径的两段时间相乘,以负指数衰减,再除以中间好友的好友数平方根,最后求和。重点是同时降低陈旧关系路径和超级连接者的贡献。实践中必须定义δ的含义、单位及零值处理;该公式与“-0.3”未核实为Facebook官方方案,不能作为平台经验参数直接照搬。
还要区分:两条关系的建立日期差得远不远,与它们距离现在多久是两个特征。两条十年前同日建立的关系,日期差很小,却不新近。
如果要检验“新近关系权重更高”,可从一个定义清楚的示例模型开始:
这里a是关系建立至今的天数,d是中间好友的好友数,λ控制衰减速度,单位为每天。它是可测试的设计示例,不是某个平台的公开生产算法。
假设两个中间好友各有100位好友,λ取0.01,图中两条路径的贡献分别约为0.0896和0.00000415。差距如此大,正好提醒团队:衰减参数会强烈改变排序,应与不加时间的共同好友基线比较,而非凭直觉设定。
还可以加入最近一次有效互动、近期互动频率等特征,避免一律压低老关系。训练和评估时,只能使用推荐时刻以前的数据,不能用后来形成的关系预测过去。
最终检查的应是双方接受后是否产生有意义的互动,同时观察忽略、屏蔽和投诉。标签让用户理解推荐,算法帮助发现机会,是否建立联系仍由用户决定。