用户很多,增长却可能始终发生在同一拨人中。原因之一是关系网络并不均匀:有些人彼此频繁互动,有些群体之间只有少量连接。只看总用户数和好友数,容易忽略这种结构。
社区发现算法尝试从连接中识别关系相对集中的群体。它能帮助团队选择覆盖范围、理解传播边界,但不能直接告诉我们谁一定愿意分享。
一、先定义关系,再寻找圈层
这里的“社区”是算法识别出的节点集合,不一定对应已经建好的群聊,也不一定有共同身份。常见目标是找到内部连接相对密集、对外连接相对稀疏的群体。
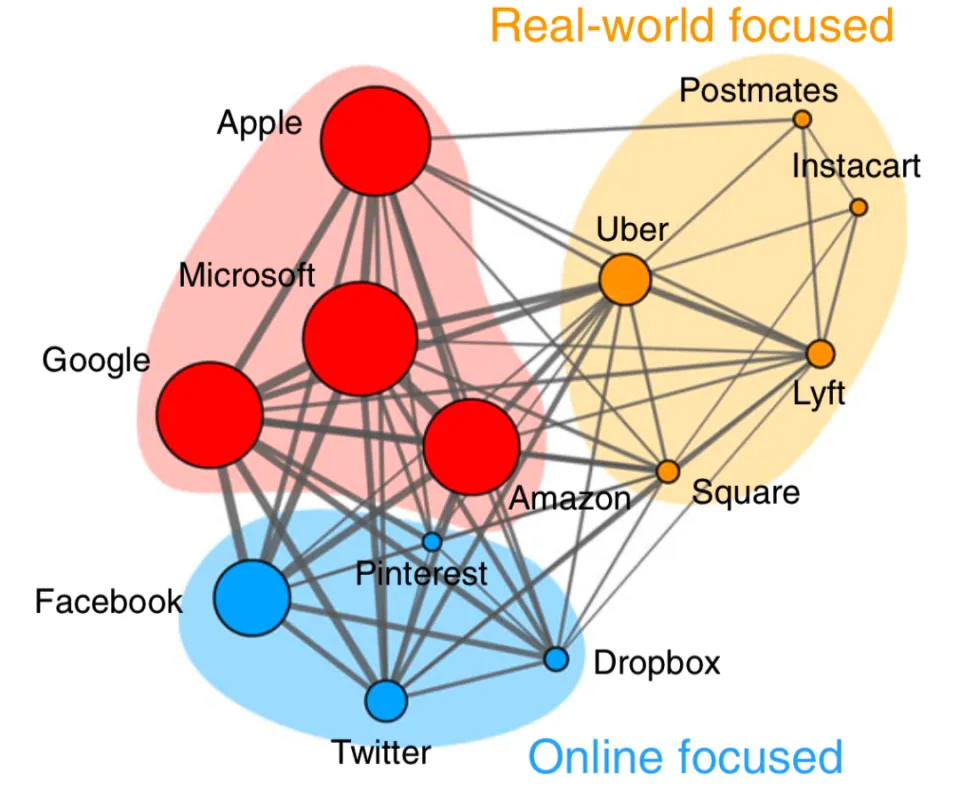
图中以公司为节点,连线表示企业之间的联系,并用颜色区分不同群体,标出偏线上与偏现实世界的业务方向。重点是连接结构可能提供行业分群线索。若把边定义为员工流动,就可以研究人才流动圈层;但该图的数据来源、时间和规模口径未核实,不能把颜色直接当作经验证的企业分类或当前市场结论。
用于社交增长时,建图要先回答三件事:节点代表用户还是组织,边代表好友还是有效互动,权重代表次数、时长还是其他强度。例如,可以用固定时间窗内的双向有效互动构建加权图;单向关注则应保留方向,或明确对称化规则。
这些选择会改变结果。把所有同群用户两两连边,可能制造一个并不真实互动的大团;把系统群发计入关系强度,也可能把运营动作误当成用户联系。建图口径比先选一个流行算法更重要。
社区划分只能提供结构。给社区命名、解释兴趣,以及识别核心成员或跨圈连接者,都需要额外的行为证据和节点分析,不能由社区编号直接推出。
二、模块度Q:内部连接是否超出了随机预期
模块度将某个划分中的实际内部连接,与保留节点度信息的随机基准进行比较。它衡量的是相对于基准的集中程度。
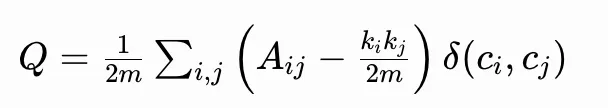
图中Aᵢⱼ表示实际连接,kᵢkⱼ/(2m)表示随机基准下的期望项,δ只在两节点属于同一社区时取1。重点是“实际减预期”,而非单纯数内部边。无向无权图中m是边数、k是度;加权图中则对应总边权和加权度,有向图需要相应公式,不能混用。
也可以按社区理解:
L是社区内部边数,d是该社区所有节点的度数之和。假设两个三角形之间只有一条桥接边,全图7条边;按两个三角形分组,每组内部3条边、度数和7,Q约为0.357。若所有节点归为一组,Q为0。这个例子说明为什么分组可能更符合网络结构。
Q适合在同一张图、同一目标定义下比较划分,但它不是业务效果分数。不存在通用的“0.3以上优秀”标准,Q超过0.7也不能单独证明过拟合。
三、Louvain:移动节点,再把社区压缩成节点
Louvain由Blondel等人提出,是一种高效寻找较高模块度划分的启发式方法。它与直接逐对合并社区的贪婪方法不同,核心是交替执行节点移动与网络压缩。
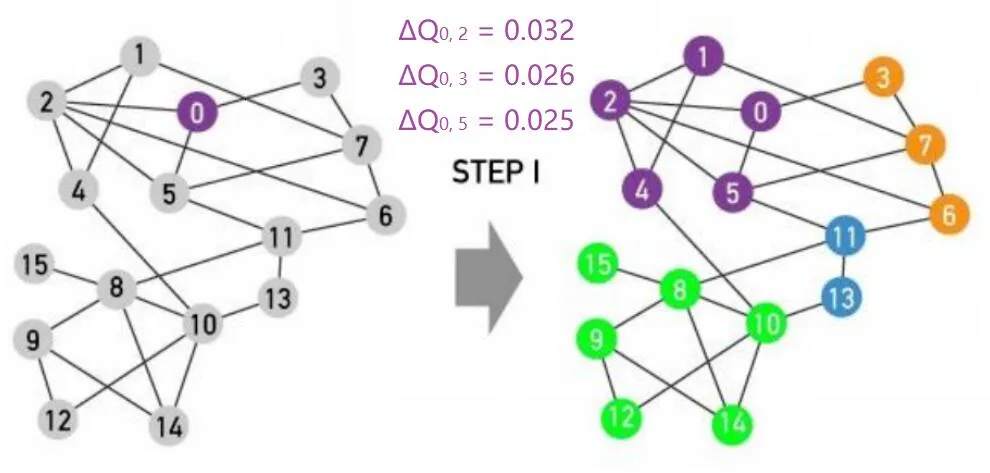
图中节点从初始状态逐步形成不同颜色的分组。重点是尝试迁入邻居所在社区,比较移动前后的Q,选择净增量最大的正收益方案。工程上需要反复遍历;结果可能受节点顺序影响,不能把一次局部选择看作全局最优。
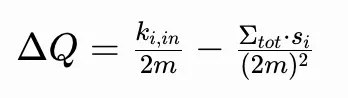
图中的ΔQ写法表达“新增内部连接收益减去随机预期项”的思路。重点是相邻边多仍需扣除基准影响。实现时必须核对边是否双计、m与各符号的定义,并计算离开原社区的损失;这张简式不能脱离计数约定,直接当作完整迁移公式。最稳妥的校验是比较迁移前后的完整Q值。
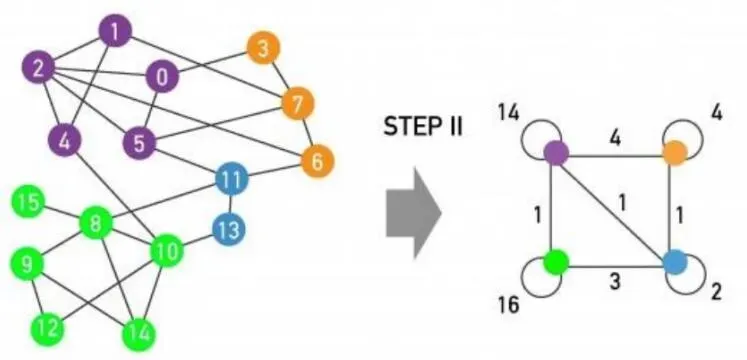
图中四个社区被压缩成四个超节点,跨社区边权相加,内部边汇总为自环。重点是压缩保留连接权重,而不只是把几个圆圈画大。自环有明确的聚合含义,不能随意删去,否则后续优化的目标就变了。
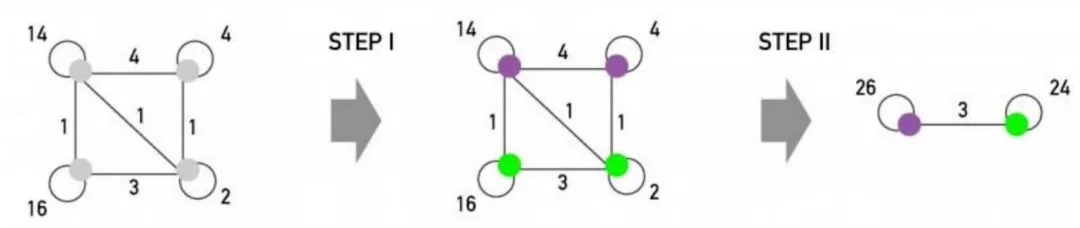
图中四个超节点继续合并为两个,展示从细到粗的层级结构。重点是算法会在新网络上重复局部优化与压缩,直到没有足够增益。业务可以检查不同层级,但最粗的一层不一定最适合运营,算法停止也不表示找到了唯一正确答案。
四、从分群结果到增长决策,还要做两层验证
第一层验证是:这个划分是否稳定、可解释。
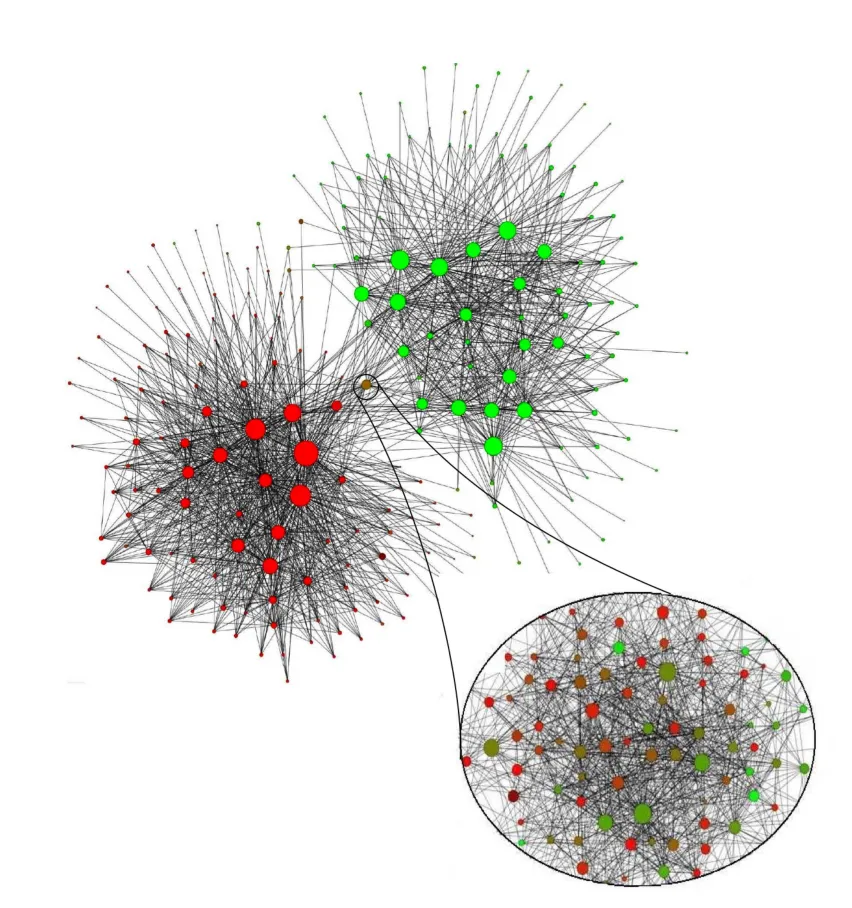
图中每个节点代表一个社区,大小对应人数,红绿表示法语与荷兰语倾向;只绘出超过100人的社区,放大区域呈现更细的子社区。重点是通信结构与语言分布存在对应。实践中可用独立属性检验分群意义,但群体的主流语言不能替代个人偏好,也不代表每个成员都符合标签。
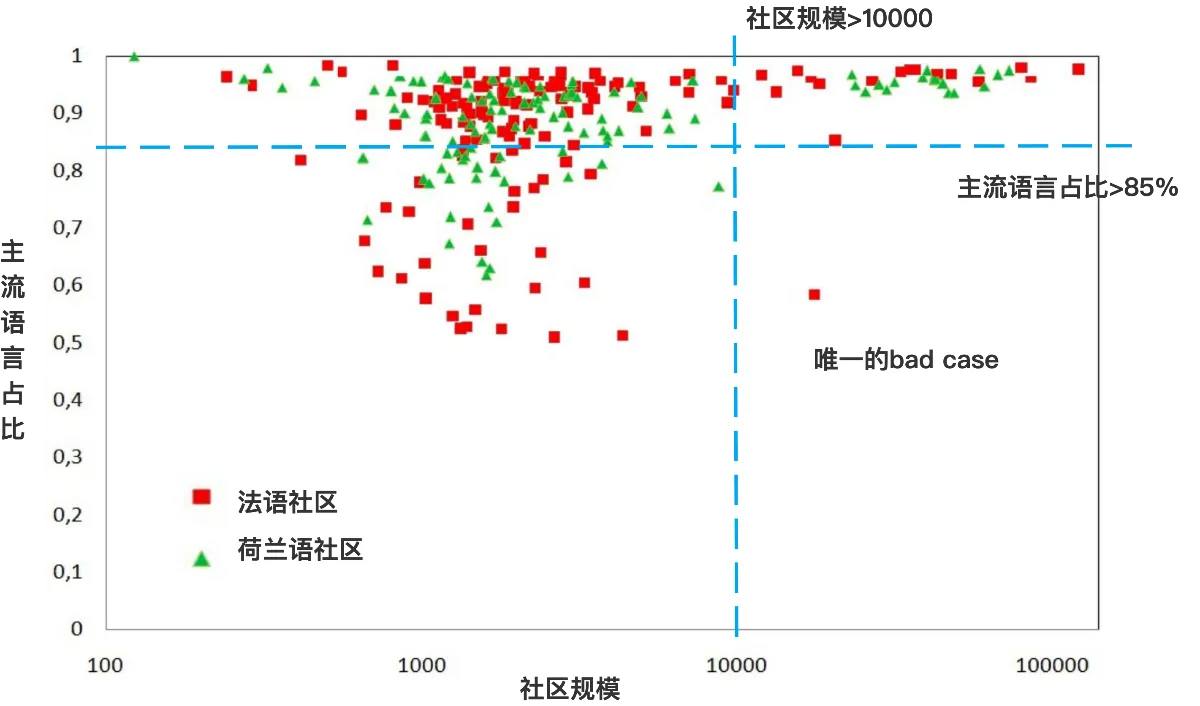
图中横轴是社区规模,纵轴是主流语言占比。原研究发现,超过一万人的社区中,除一个外,主流语言占比均超过85%。重点是用外部信息验证结构,而非只看Q。图中的“bad case”只是语言混合程度较高,不足以证明算法出错;这也不是85%的预测准确率。
实际项目应更换随机种子、时间窗口和合理的边权设置,检查成员是否大幅变动,并抽查社区内部连接。标准Louvain每层给出非重叠划分,无法完整表达一个人同时属于同事、家人和同好圈的现实。
还要注意两项技术局限:模块度优化可能把小而清晰的社区合并,尺度取决于整体网络,并不存在统一的最小人数线;Louvain也可能产生连接较差甚至不连通的社区。Leiden改进了后一个问题,但若仍优化模块度,并不会自动消除模块度本身的分辨率限制。
第二层验证是:按社区采取行动,是否产生有效增量。
| 业务用途 | 可以尝试的动作 | 需要验证的结果 |
|---|---|---|
| 种子用户选择 | 在不同社区分散选择候选人,减少名单重叠 | 是否覆盖更多目标用户,而非重复触达同一圈层 |
| 内容与活动适配 | 用真实需求样本解释社区,再设计小规模测试 | 有效参与、留存是否改善,投诉是否上升 |
| 跨圈传播 | 观察连接多个社区的用户与实际传播记录 | 是否带来新的有效参与,避免把桥接位置等同于影响力 |
例如,十位候选人都来自一个密集圈层,即使各自好友很多,触达对象也可能高度重合。可比较“集中选择”与“跨社区选择”的实际覆盖和后续使用,同时控制预算、内容与接收负担。
社区是分析工具,不是固定身份。它适合帮助团队提出和验证增长假设,不应成为自动骚扰、推断敏感属性或仅凭关系密集就认定作弊的依据。