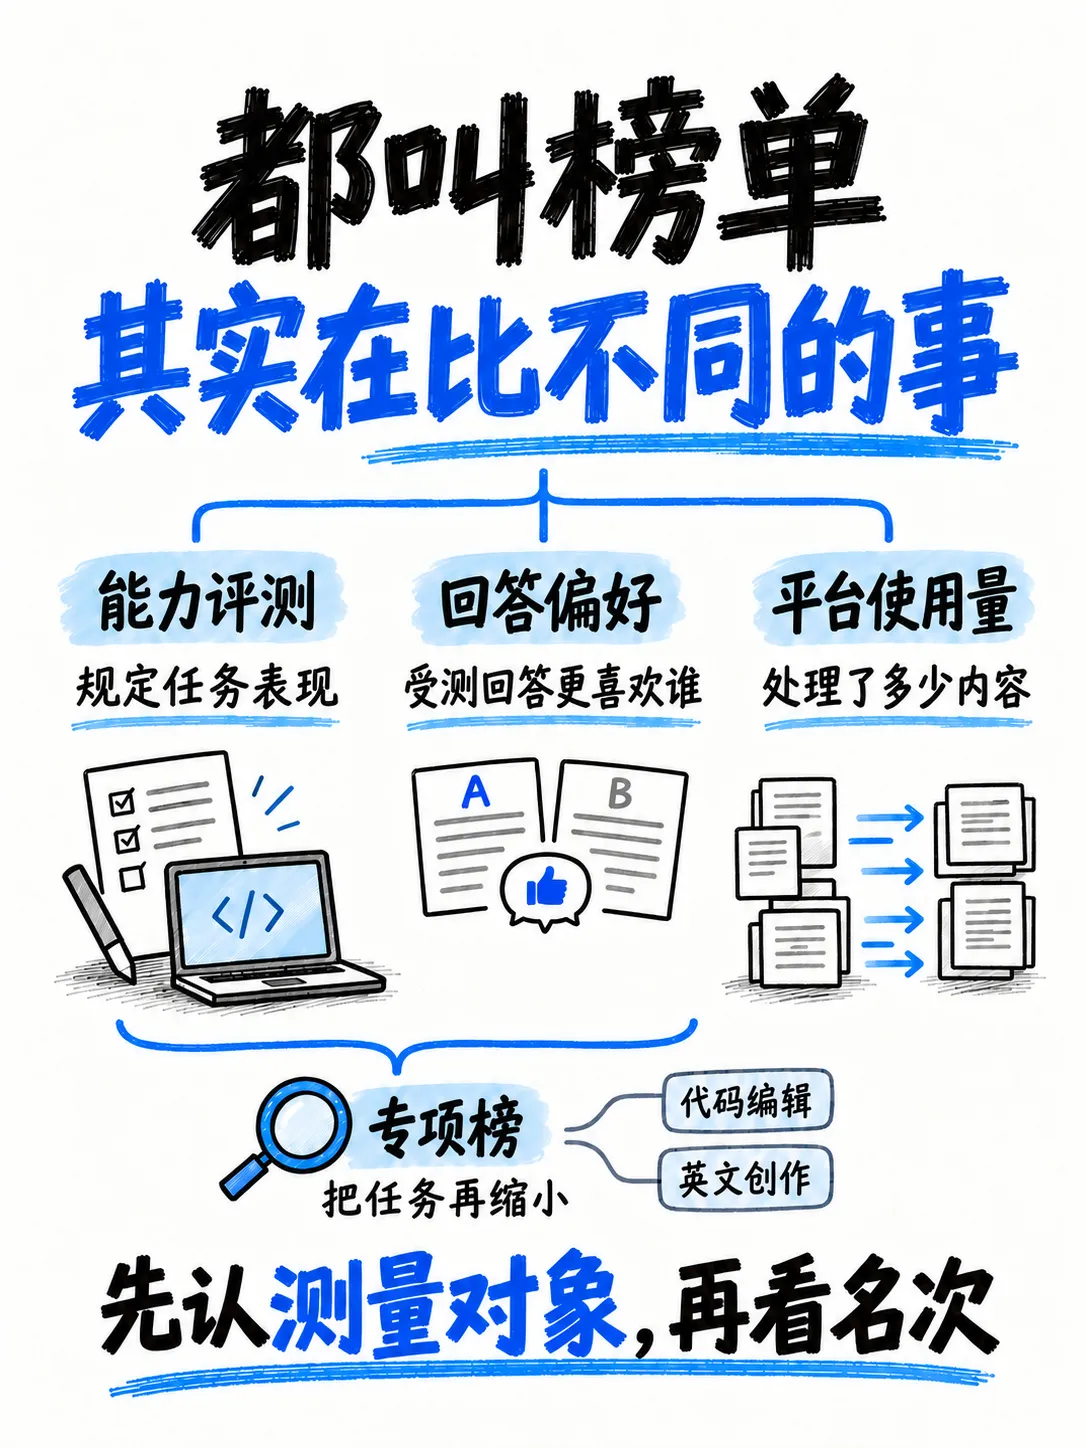
大模型发布常用评测图表回答“这次强了多少”。这些成绩让能力变化容易被比较和转述,也给用户一个进一步了解的理由。但做题分数、回答偏好和平台使用量,证明的是不同事情。
选榜前先确定:希望哪类用户,因为哪项能力进步,愿意测试产品?代码工具应优先解释代码修改与执行,长文档助手应展示信息如何被有效使用。名次帮助产品进入候选,能否采用仍要落到实际任务。
一、模型发布主要打哪些榜
1.1 从发布材料看,厂商在争取什么判断
下面四次海外发布集中于2025年春季,用于比较成绩的组织方式,不代表当前排名或全行业规律。
| 发布案例 | 重点评测 | 希望建立的使用理由 |
|---|---|---|
| GPT-4.1 | SWE-bench Verified、MultiChallenge、IFEval、MRCR | 代码、指令遵循与长材料处理[1] |
| o3、o4-mini | AIME、Codeforces、SWE-bench、MMMU | 推理、编程、视觉与工具使用[2] |
| Gemini 2.5 Pro Experimental | LMArena、GPQA、AIME、HLE、SWE-bench Verified | 用户偏好、复杂推理与代码能力[3] |
| Claude 4 | SWE-bench Verified、Terminal-bench等 | 编程与持续执行任务[4] |
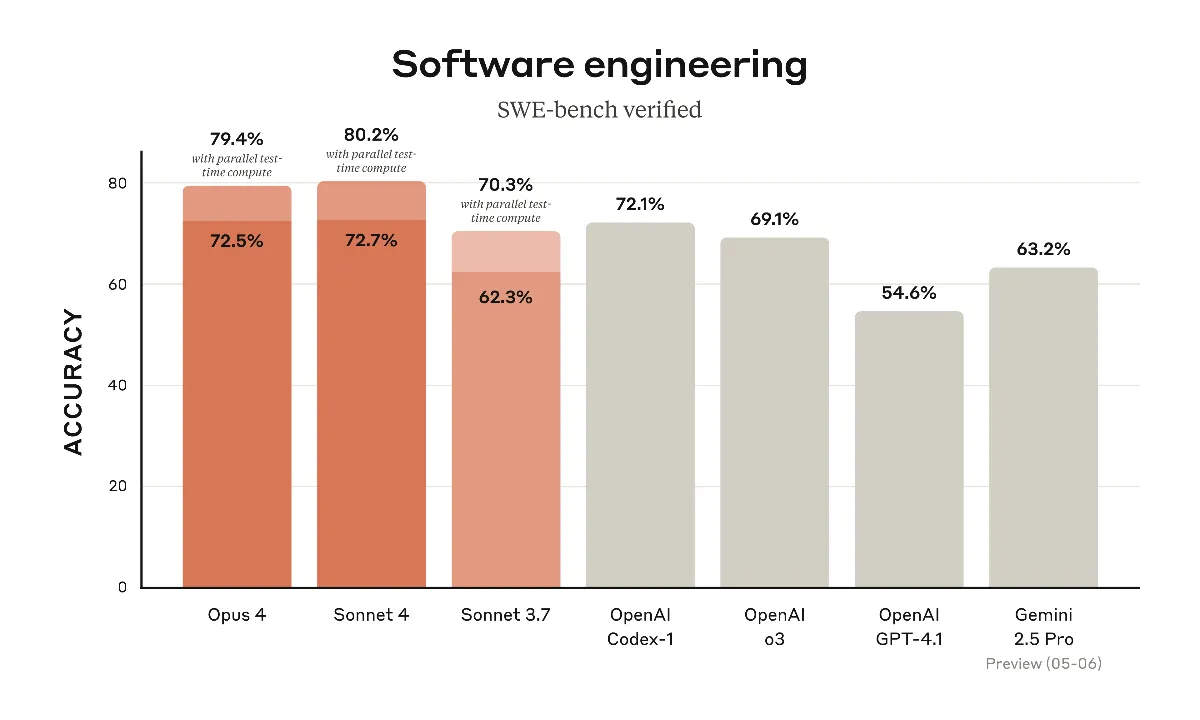
图1.5-1 Claude 4发布原图(2025年)。图中含不同计算与样本设置,不能视为统一预算比较。来源:Anthropic。[4]
厂商先突出希望用户记住的变化,再组织相应成绩。应用团队还要说明:用户能测试什么,运行条件与评测有什么差别。底层模型的高分不能直接改称应用的任务完成率。
1.2 “打榜”包含固定试题、公开排名和用户偏好
AIME、GPQA等首先是任务集,厂商可以自行运行;Arena通过回答对比与投票形成偏好排名;Artificial Analysis按公布的方法组织综合评测。[5][6] 引用基准不等于取得第三方独立认证,还要核对谁运行、谁复核。
按问题选择入口:看回答偏好,查Arena相应类别;看综合能力,查Artificial Analysis并下钻分项;看平台使用,查OpenRouter;看特定任务,查相关专项榜。[5][6][17] 三类排名的计量对象不同,不宜平均成一个“总名次”。
二、这些评测究竟比拼什么能力
2.1 把常见榜单与基准放回测量对象
先看任务是否相关,再检查运行与复核、方法公开、判分方式及维护状态。平台复测通常更便于比较,但仍有设置差异;人类投票适合研究偏好,确定答案适合相应客观任务,不能简单排成权威梯队。
| 榜单或基准 | 主要比较什么 | 引用时注意 |
|---|---|---|
| Arena偏好榜 | 受测回答中的用户偏好 | 偏好不等于正确性,需看类别与名次区间[5] |
| Artificial Analysis指数 | 按公开方案汇总多项能力 | 主要基于英文文本;版本、权重及其他独立评测须分清[6] |
| MMLU | 多学科知识与问题求解 | 分数不代表专业资格;变体另注明[7] |
| GPQA Diamond | 高难度科学问答 | 子集要一致,不代表独立科研能力[8] |
| AIME | 指定年份的竞赛数学 | 有无工具、多次采样应分开[2][3] |
| HLE | 跨领域高难度知识与推理 | 数据、工具和判分设置影响结果[9] |
| MMMU | 图文结合的多学科推理 | 不覆盖全部视觉生成或编辑能力[10] |
| LiveCodeBench | 持续更新的代码任务 | 注明题目时间窗口与任务类型[11] |
| SWE-bench Verified | 按仓库问题修改代码 | 执行框架、样本与测试质量影响成绩[12][13] |
| Terminal-Bench | 终端环境中的智能体任务 | 比较的是模型与执行框架的组合[14] |
| τ-bench | 政策约束下的用户交互与工具调用 | 模拟任务表现不等于真实客服满意度[15] |
| IFEval、MultiChallenge | 指令约束、多轮信息保持 | 两者不同,判分方法也需注明[1][16] |
| MRCR等 | 长材料中的信息定位与使用 | 输入容量不等于有效理解[1][3] |
代码工具可先查代码和执行类结果;知识与推理产品查相应学科任务;对话和长材料产品查偏好、指令与上下文使用。分类用于查阅,各项覆盖并不互斥。
2.2 同一个分数,要把运行条件带回来
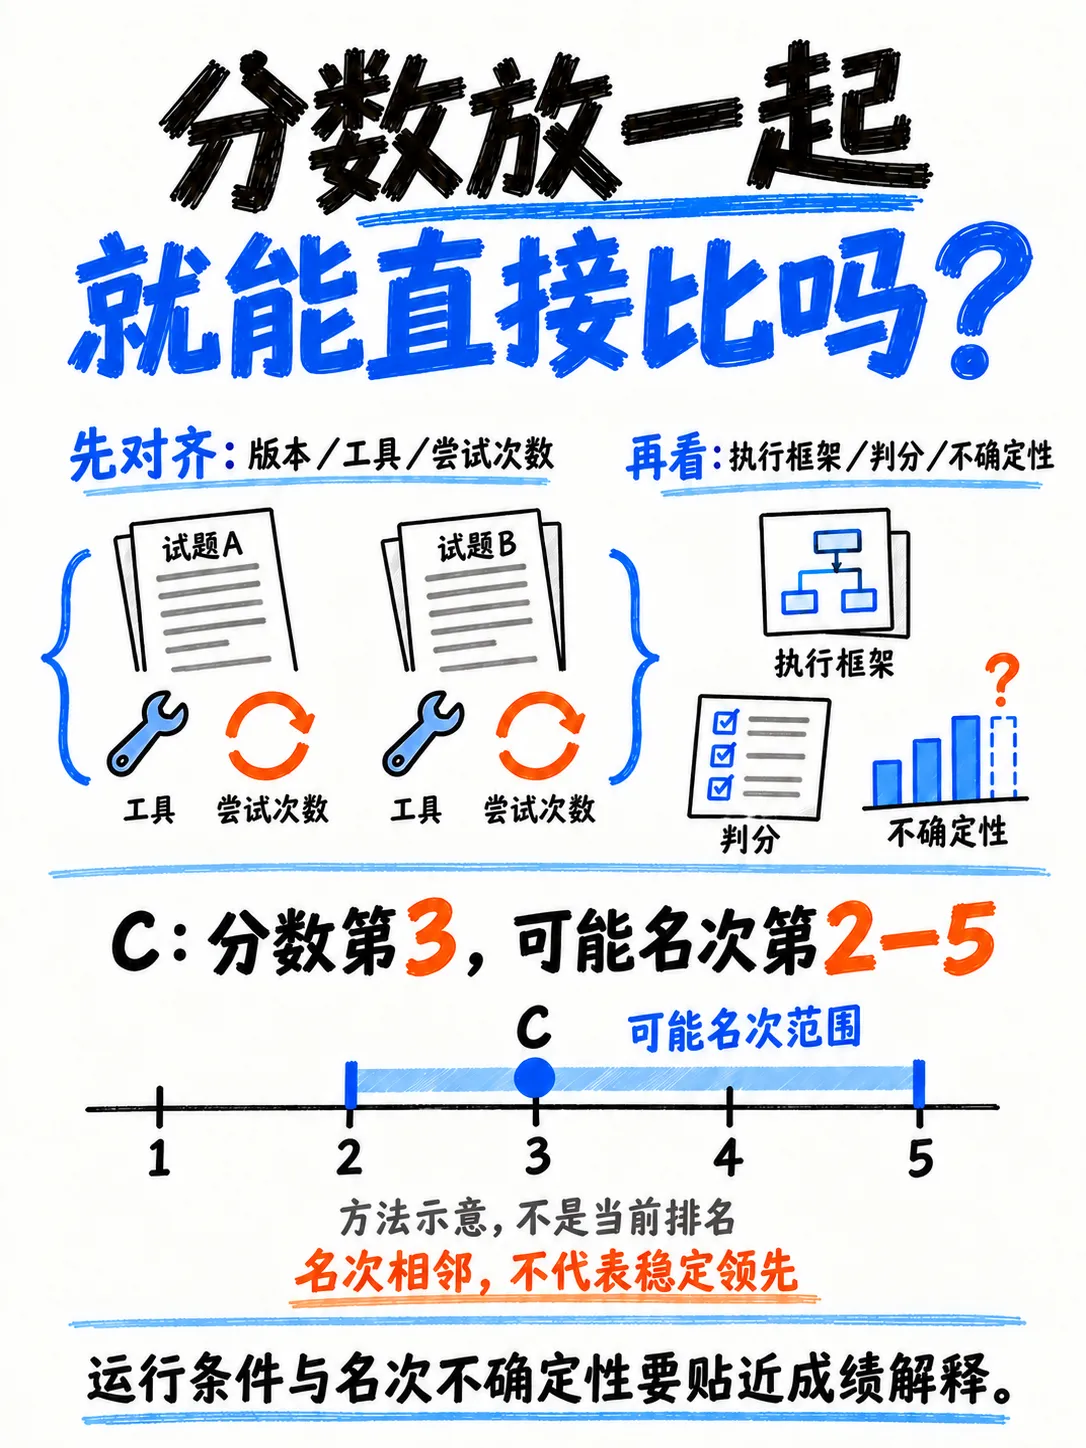
一次尝试、从多次结果中选最佳、由多数答案决定结果,是不同口径。o3、o4-mini发布文提醒,有Python工具的AIME成绩不应直接与无工具结果比较;GPT-4.1还报告了MultiChallenge更换判分模型后的差异。[1][2]
引用前核对六项:产品主张、原始出处、模型与基准版本、运行条件、计算口径、名次与不确定性。关键条件靠近成绩,详细方法保留入口;资料缺失时缩小主张。
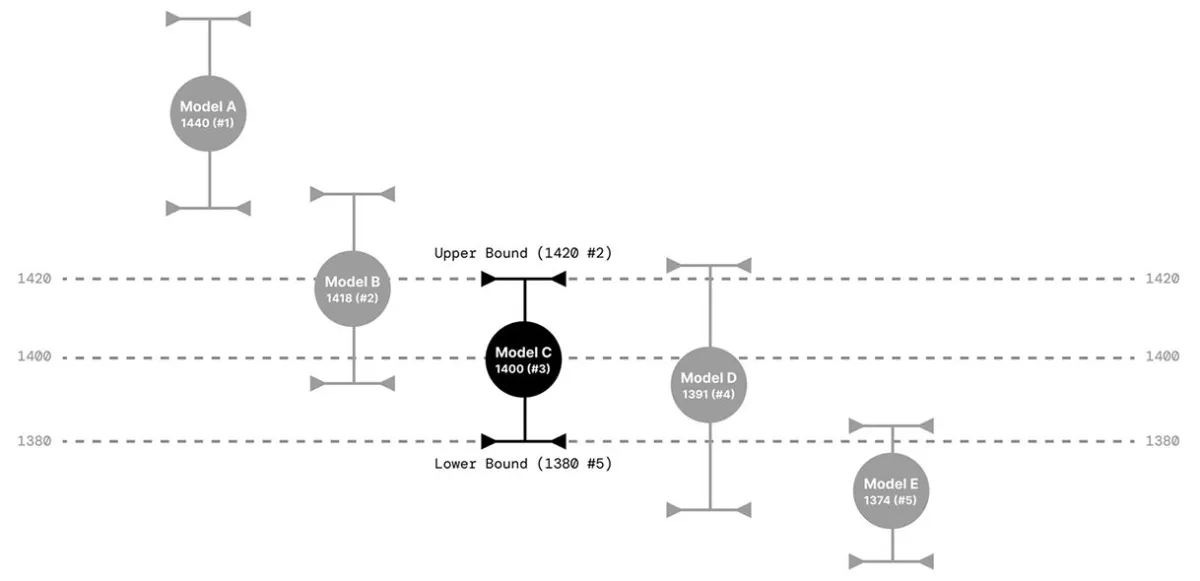
图1.5-2 C的分数排第三,可能名次范围却是第二至第五。来源:Arena方法示意图。[5]
Arena展示分数与可能名次范围。[5] 表格中一前一后,不一定代表差异稳定存在;结果相近时,应继续比较实际任务、成本和时延。
2.3 权威评测也会过时,不能永久借用旧成绩
2024年,OpenAI与原作者推出人工筛选的500题SWE-bench Verified。2026年2月,OpenAI因任务和污染问题停止报告该成绩,建议改用Pro;7月又公布Pro公开题集审查,报告测试过严、需求不足等问题,并撤回推荐。[12][13][24]
这是该公司的审查结论,不能外推私有题集的全部质量。换新榜仍需检查任务。停止引用也不等于项目退役:SWE-bench官网仍提供Verified入口。[25] 停更、部分候选上的能力饱和、训练污染,应分别核验。
三、调用量榜与匿名模型:让试用先于品牌揭晓
3.1 调用榜展示采用行为,但采用行为也有口径
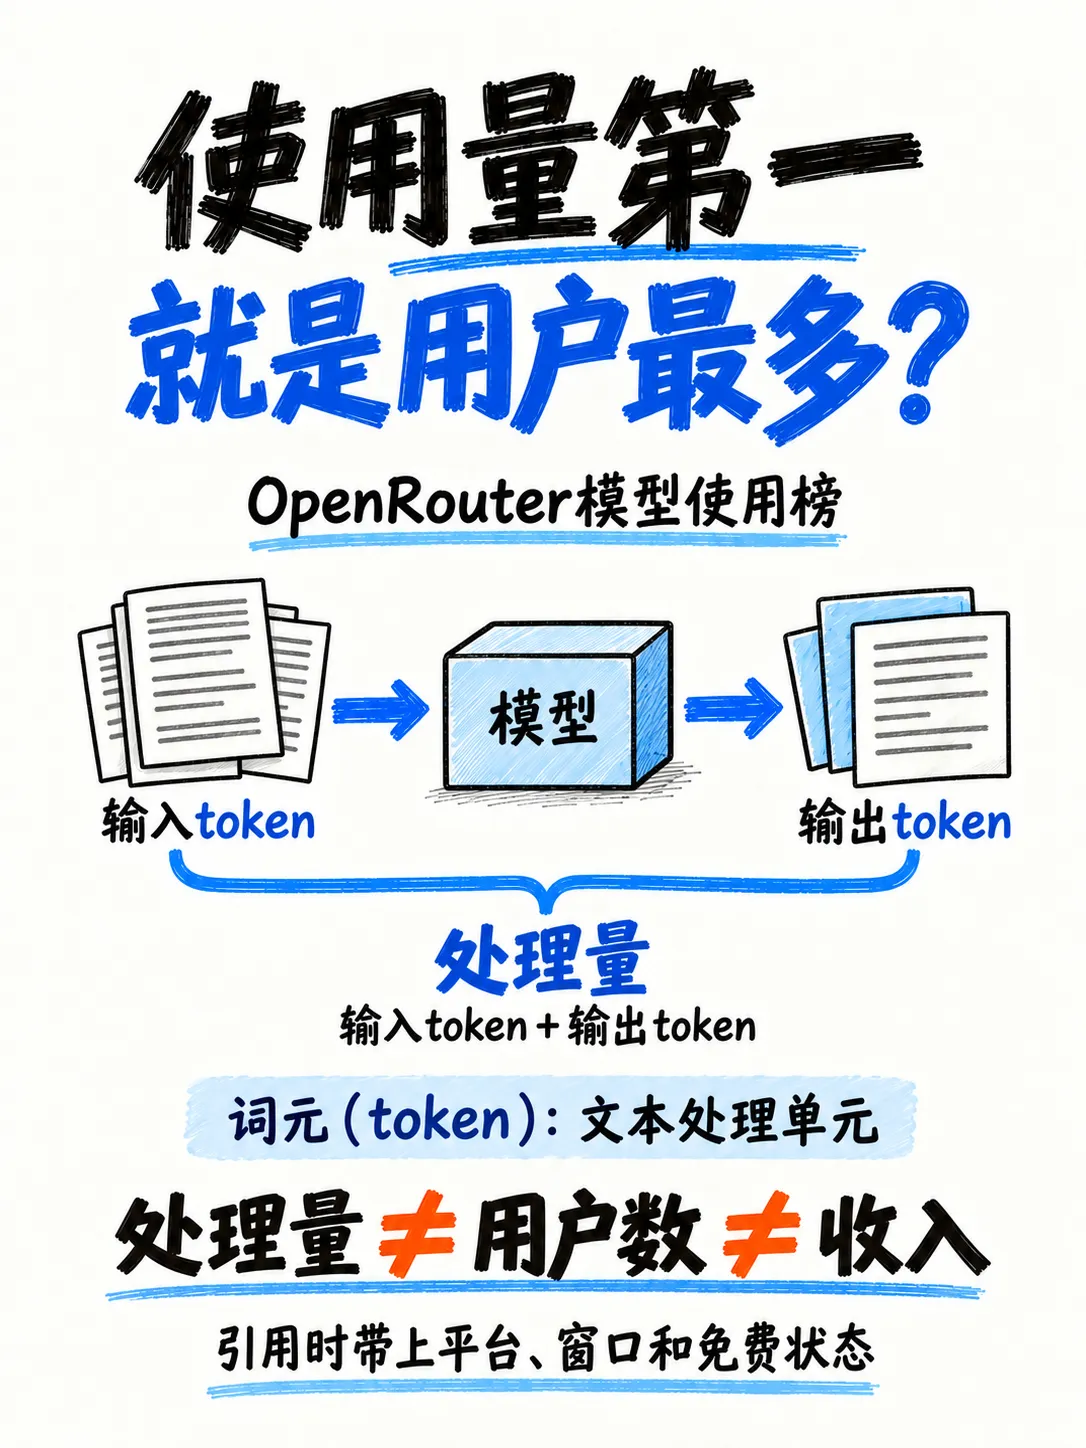
OpenRouter模型使用榜目前按平台API处理的输入与输出token合计排序,免费等变体分列,私密请求不纳入公开汇总。[17] 一次长文档或智能体反复请求就可能产生大量token,不能换算成独立用户或收入。
使用热度提供发现入口,引用时须带上平台、窗口、单位与免费状态。后续仍需让接入者查到能力、价格和试用条件。
3.2 Quasar与Optimus:匿名试用后揭晓,确有其事
2025年4月3日、10日,OpenRouter分别上线免费试用的Quasar Alpha、Optimus Alpha;14日揭晓二者是GPT-4.1大模型版本的早期测试。公告目录称它们测试期曾领跑榜单,但未列明榜型、窗口和名次。[18][19]
从传播过程看,匿名上线、试用比较、身份讨论与正式揭晓可以形成连续话题;现有资料不足以证明“成绩好才认领”或具体获客效果。
团队借鉴时应明确:测试身份与免费条件,揭晓后的名称、价格和接口,以及旧集成怎样迁移。案例中可确认的退役措施,是旧端点返回404,避免自动转到收费版本。[19] 用户知道是谁做的之后,还要知道下一次请求会发生什么。
3.3 匿名测试有合理用途,也有选择性披露的问题
Arena允许未发布模型以匿名标签测试,结果先交给厂商;公开后,相关分数按政策保留初步标记,直到获得足够新投票。[20] 这与API免费试用榜不同。
若测试多个版本、只公开最好结果,就可能出现选择效应。《The Leaderboard Illusion》讨论了这类机制问题。[21] 读者应核对测试与最终版本是否一致、公开了哪些结果,不能据匿名本身认定作弊。
四、专项榜为什么也能影响专业用户
4.1 Aider:把“会写代码”缩小为能否完成代码编辑
Aider Polyglot用六种语言的225个练习评估工具内代码编辑,列出正确比例、费用、编辑格式与运行资料。[22] 对准备接入这类工具的人,这比泛称“编程强”更便于检查。但它仍受工具与任务设置限制,维护者也经营相应工具。
4.2 EQ-Bench创作榜:能比较风格,不代表文学定论
EQ-Bench Creative Writing v3用模型裁判评价英文创作,提供评分、排名及重复表达等观察。[23] 它能帮助筛选风格,裁判偏好却不等于目标读者审美,英文表现也不能直接换算中文质量。专项榜的价值在于问题更具体,仍要读方法与实际输出。
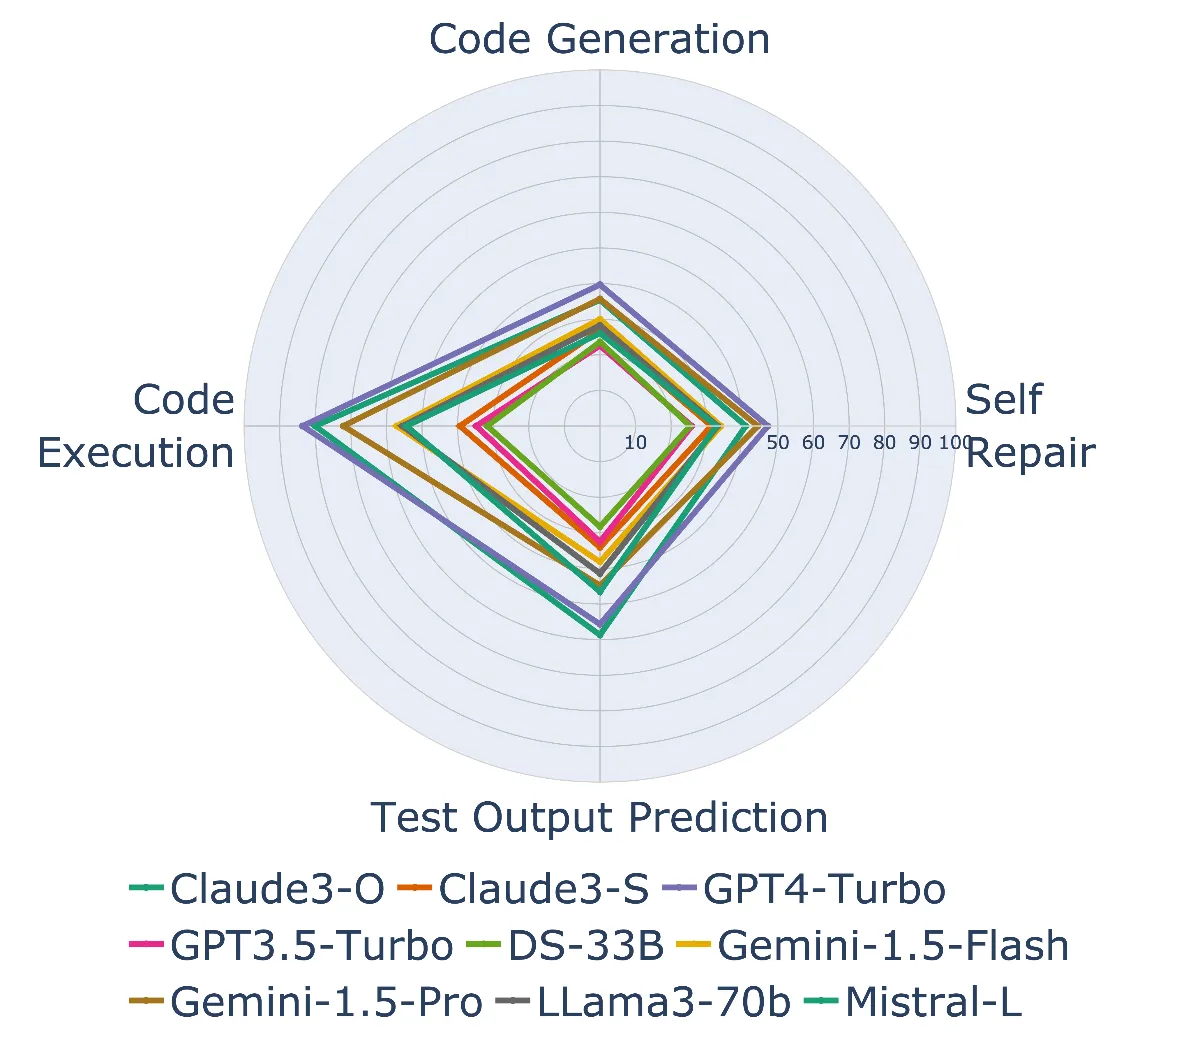
图1.5-3 代码生成、自修复、代码执行、输出预测,呈现不同任务侧面。来源:LiveCodeBench历史研究图,不作当前排名。[11]
4.3 任务结构不同,总排名就可能反过来
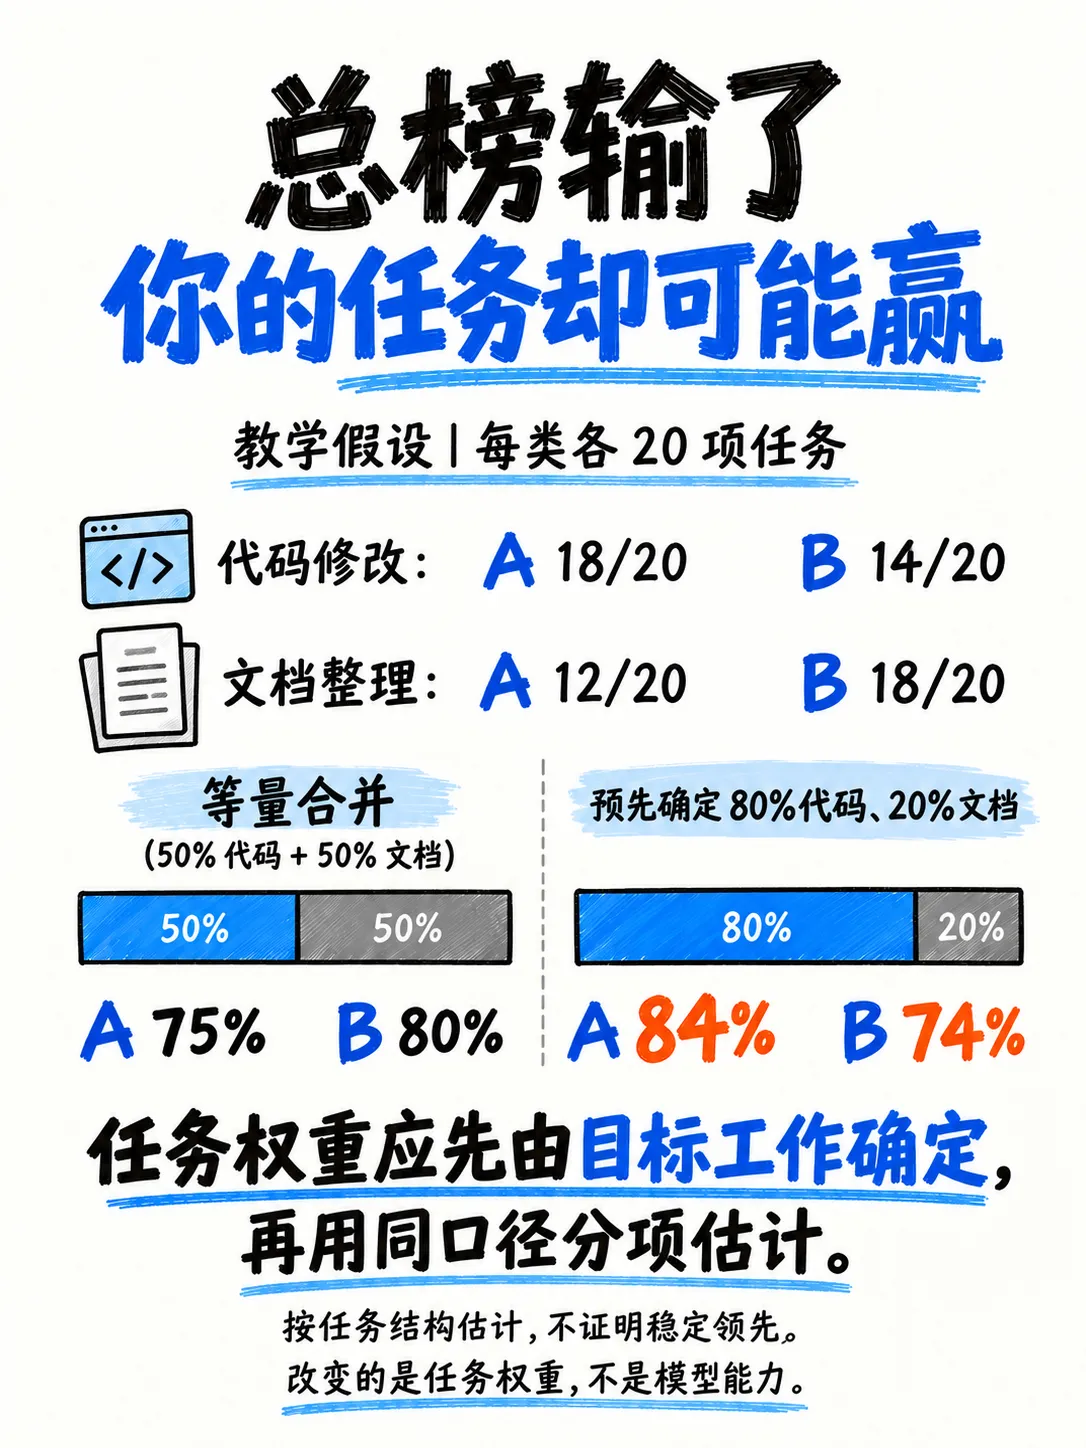
以下为教学假设。各用20项任务,以相同标准测试两个候选:
| 候选 | 代码修改 | 文档整理 | 合并完成比例 |
|---|---|---|---|
| A | 18/20=90% | 12/20=60% | 75% |
| B | 14/20=70% | 18/20=90% | 80% |
等量合并时B更高;若目标任务预先确定为80%代码、20%文档,暂用分项结果估计:
总排名随任务结构改变。权重应来自目标任务,每类20项也不足以证明稳定领先。营销可以说明具体优势,再让用户核查成本、时延与结果。