一个新的AI项目出现时,读者可能还没运行过它,先看到了仓库右上角的Star。几千、几万颗星,把陌生项目变成了“很多人已经关注”的项目。这个数字容易理解、容易转发,也容易进入团队介绍和融资材料。它为什么在AI时代受到重视,要从代码生产方式与GitHub的双重角色说起:这里既是开发现场,也是公开的项目发现与声誉展示场所。
一、AI让代码更容易生成,也让版本与协作更重要
先分清两个名字。Git是版本控制工具,GitHub是基于Git提供代码托管与协作服务的平台。 Git可以只在本地使用,也可以与其他托管平台配合;本节讨论的Star属于GitHub,不能称为“Git的Star”。
Git解决的是文件不断变化以后,怎样保留和管理历史的问题。开发者可以把一组修改记录为一次提交,查看改了什么,比较不同版本;需要尝试另一种实现时,可以建立分支,确认有效后再合并。出现问题,也有历史可以追查和恢复。多人协作时,这些记录帮助大家处理彼此的改动。[1]
AI降低了生成代码的门槛,却没有替人消除版本管理问题。一个原本不会写代码的人,也可能通过自然语言让工具生成网页、脚本或应用;当他继续要求修改布局、增加功能、修复错误时,就会遇到同一个问题:新版本改好了哪里,又弄坏了哪里?本书据此判断,代码越容易批量产生,保留可比较、可恢复的版本就越有价值。操作者可以通过图形界面或智能体完成部分操作,不必先熟记全部Git命令,但仍需理解自己保存、合并和发布了什么。
GitHub又把项目的协作过程放到了同一个入口:README解释用途,Issue记录问题,Pull Request提交待审查的修改,公开仓库允许他人查看材料和参与协作。对AI项目,仓库还可以连接论文、模型权重、安装说明、演示和调用示例。用户从“听说一个新工具”走到“检查它能不能用”,因此少了几次寻找材料的跳转。
这也解释了为什么GitHub会进入增长工作。项目团队不仅在这里存代码,也在这里被发现、被比较和被追问。公开材料是否清楚、示例能否运行、问题是否有人回应,会直接影响陌生人是否愿意继续尝试。
二、越来越多人进入GitHub,但增长数据要看对口径
GitHub的2025年Octoverse报告显示,平台开发者总规模超过1.8亿,当年新增超过3600万;平均每月合并4320万个Pull Request,同比增长23%,全年代码提交接近10亿次,同比增长25.1%。报告还称,近80%的新开发者在加入首周使用了GitHub Copilot。[2]
| 2025年官方披露 | 可以支持的判断 | 不能直接推出的判断 |
|---|---|---|
| 开发者总规模超过1.8亿,年新增超过3600万 | GitHub的参与规模继续扩大 | 这些人全部每天活跃,或全部是编程新手 |
| 月均合并4320万个Pull Request,同比增长23% | 协作修改活动增加 | 每次修改都产生同等价值,或都由AI完成 |
| 全年代码提交接近10亿次,同比增长25.1% | 版本记录活动增加 | 提交增长等于软件质量或收入增长 |
| 近80%的新开发者首周使用Copilot | AI工具已进入大量新加入者的工作方式 | AI单独造成了全部新增账号 |
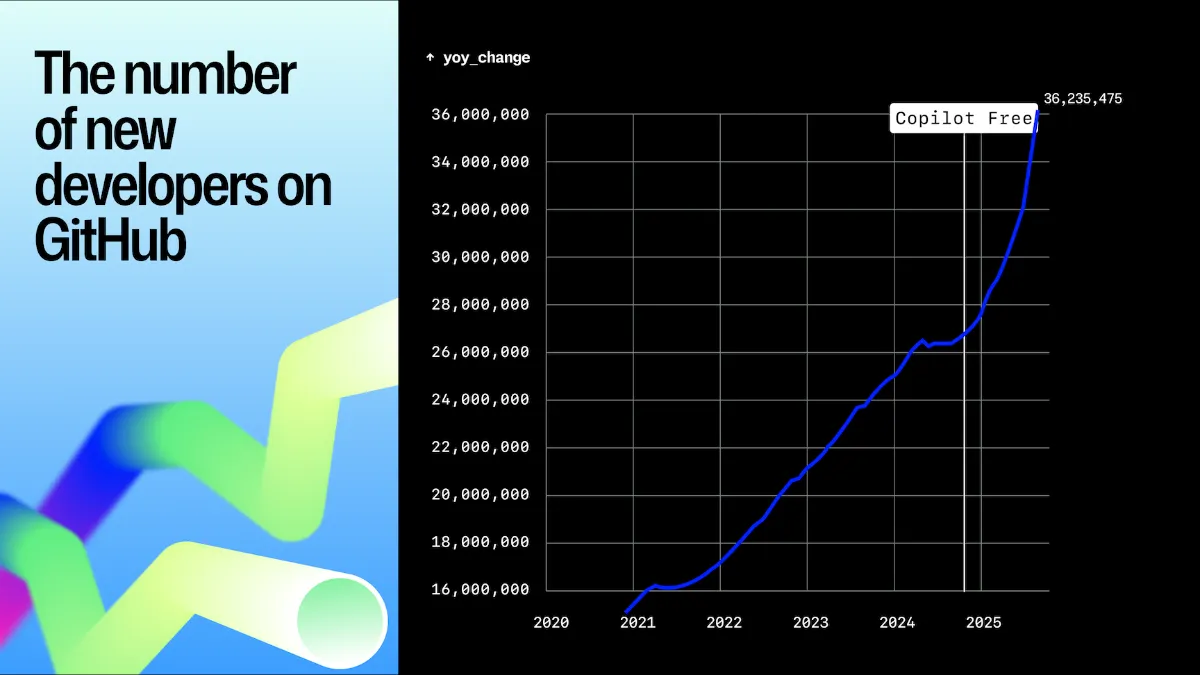
图1-6-1 GitHub官方披露的新增开发者趋势。2025年图示值为36,235,475;这是新增规模,不是DAU。Copilot Free标记表示发布时点,曲线本身不能分离其因果效果。来源:GitHub《Octoverse 2025》。[2]
这些是平台自报的规模和活动数据,并非日活跃用户数(DAU)。本节未取得可比的官方DAU时间序列,因此不用“GitHub日活越来越高”代替上述事实。新加入GitHub,也不等于第一次学习编程。
对增长团队,更有用的变化是:越来越多项目、示例和协作行为在这里汇集,GitHub正在成为AI产品的重要接触场所。即使终端用户不写代码,替他选型的开发者、搭建应用的同事和技术采购者,也可能先在仓库中检查项目。项目是否适合进入这里,仍取决于目标用户有没有查代码、接模型或复用工具的需求。
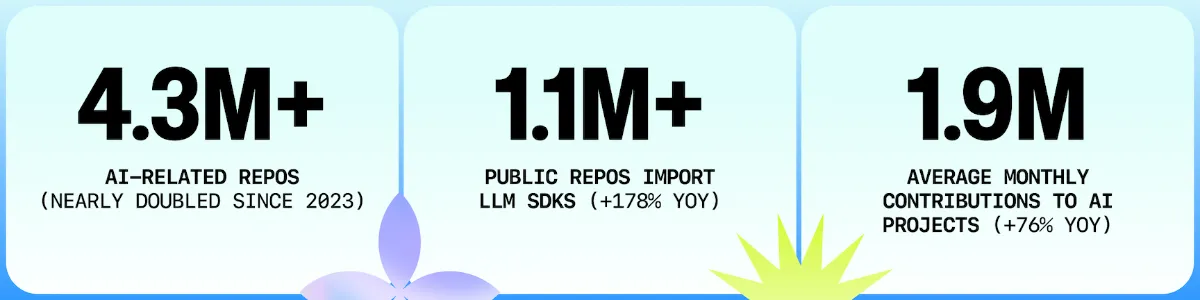
图1-6-2 AI活动在GitHub上的规模。官方2025年报告列出超过430万个AI相关仓库、超过110万个导入LLM SDK的公开仓库,以及月均190万次AI项目贡献;仓库数和贡献次数均不等于独立用户数。来源:GitHub《Octoverse 2025》原图。[2]
三、Star怎样成为产品与团队的第一印象
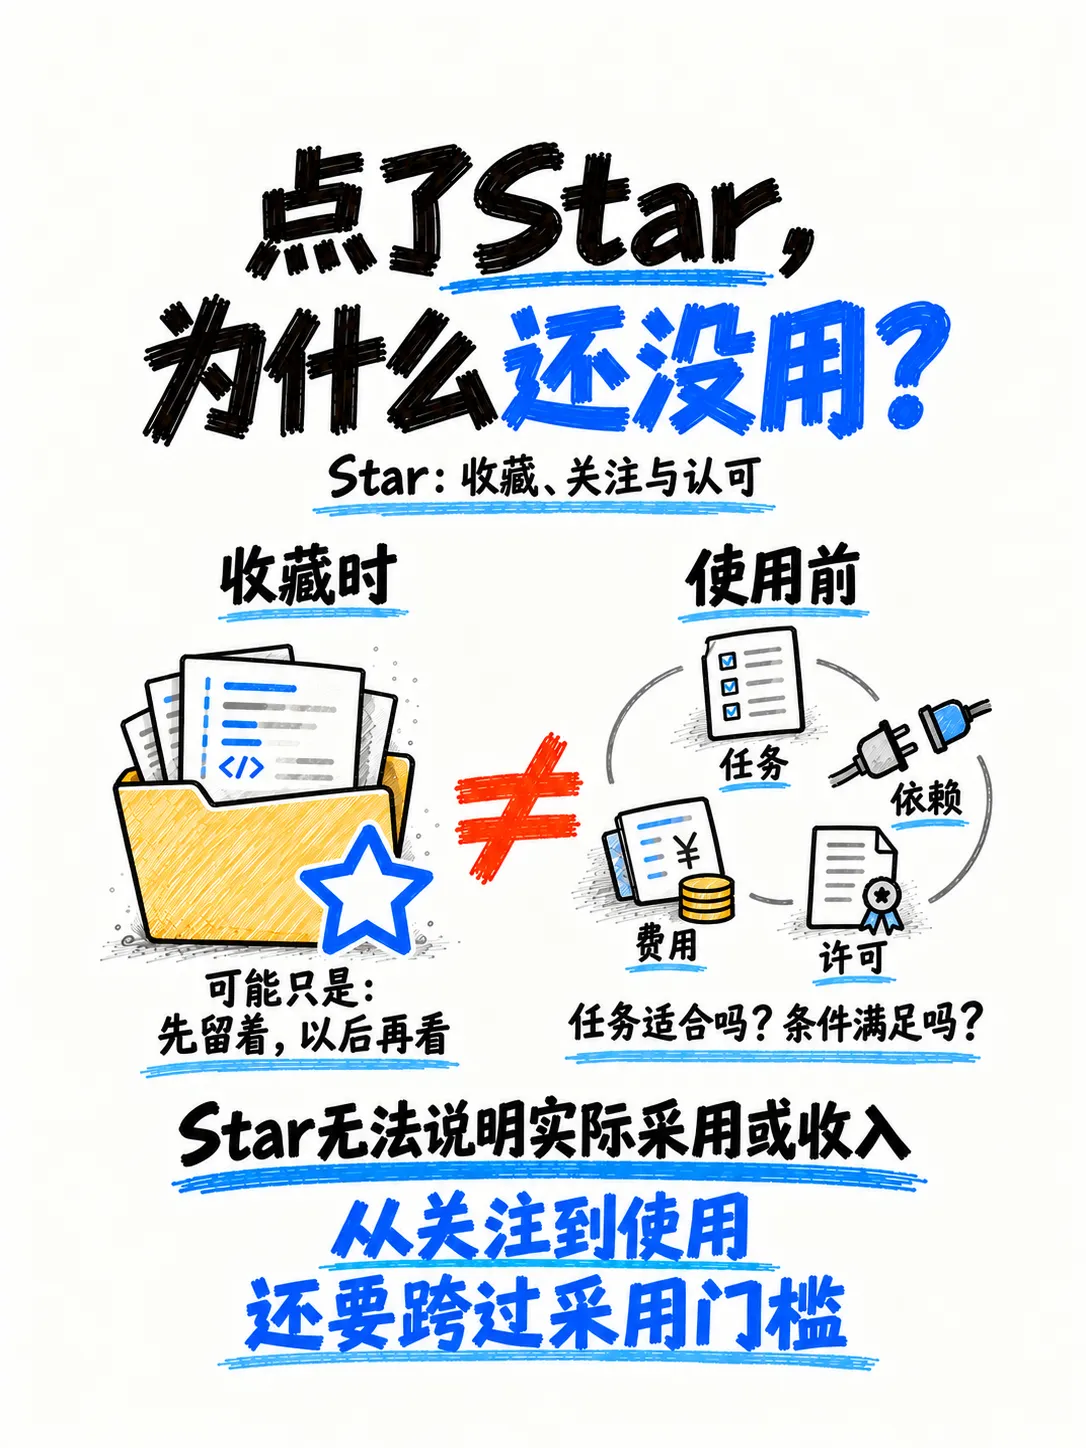
GitHub官方把Star用于保存感兴趣的仓库、方便再次找到和表达认可,并说明它与发现及部分排名有关。[3] 点一下的成本很低,累计数又公开可见,于是它能把分散的个人关注汇成一个易于传播的数字。
AI产品尤其容易借助这种信号。模型、智能体框架和编程工具更新很快,普通访问者很难逐一检查代码、复现评测和比较维护质量。面对陌生项目,“已经有很多人关注”就可能成为继续阅读的理由。有人还会把它进一步理解为“开发者认可这支团队,技术应该不错”。这后一层是从关注向能力的推断,恰恰也是Star最容易被过度使用的地方。
收藏者可能只是保存教程、关注研究方向,甚至暂时还不知道怎样运行项目。老项目累计时间更长,课程、资源清单与基础设施的受众也不相同。比较时应先确认仓库类型、公开时间和近期传播事件,再看新增关注与后续活动;不能把不同用途的仓库放在同一张Star榜上评技术高低。
投资机构确实会观察这类指标。a16z在《Open Source: From Community to Commercialization》中,将Star、提交、Pull Request和贡献者增长列为观察项目与社区关系的指标,同时另外区分实际使用和收入。[4] 这是一家机构公开表达的投资与经营方法,足以说明Star为什么会进入融资叙事,却不足以证明投资人普遍“见星就投”。
对早期团队,Star可以帮助获得第一次注意:让别人愿意打开仓库、了解创始人、安排进一步交流。要把关注变成对团队的信任,还需要拿出可运行的成果、维护记录,以及有人持续解决真实问题的证据。融资材料中的一条涨星曲线,无法替代这些材料。
因此,团队可以展示Star,但应同时回答它之后发生了什么。是否有人跑通示例?是否出现了具体任务中的反馈?是否有外部贡献被采纳?这些行为各自说明不同事情,不能与Star、下载、Fork简单相加为用户数。公开仓库能展示一部分采用过程,自部署、离线使用和付费关系还需另有可靠记录。
四、当关注可以购买:刷星产业与六百万疑似假Star
当一个数字能影响发现、选型和团队声誉,就有人开始出售这个数字。刷星市场交付的是计数:商家批量出售Star,互助群交换点星,活动组织者用奖励换取点星。即使操作来自真人账号,只要动机是完成交易,也不能把它理解为对项目的自发认可。
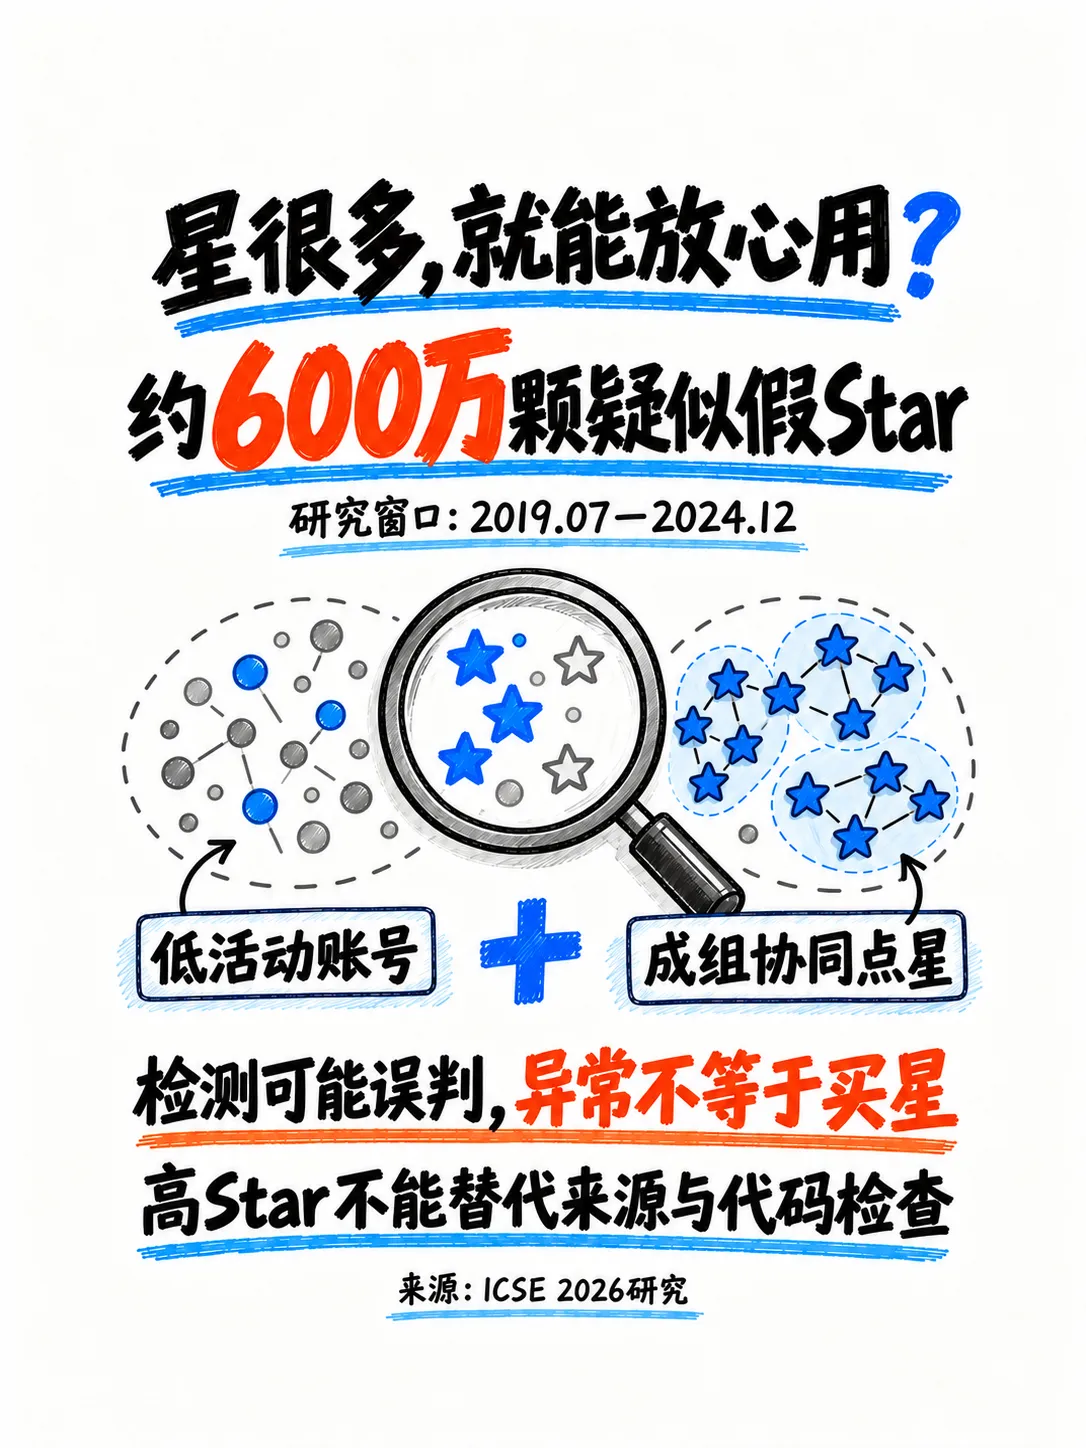
卡内基梅隆大学等机构的研究者在ICSE 2026论文《Six Million (Suspected) Fake Stars on GitHub》中,分析2019年7月至2024年12月的公开事件数据,识别出约600万颗疑似假Star,涉及18,617个疑似刷星仓库。StarScout主要检查低活动账号与成组账号协同点星的异常模式,并进一步过滤噪声;检测仍可能误判,不能仅凭异常曲线认定某个团队买星。[5]
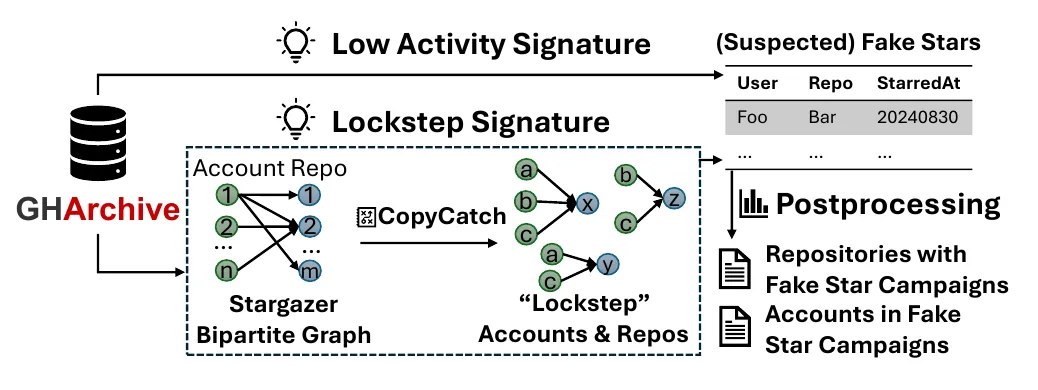
图1-6-3 StarScout的疑似刷星检测流程。研究从GHArchive事件记录检查低活动特征与成组协同行为,再经后处理识别疑似账号及仓库;结果仍可能误判。来源:He等,ICSE 2026论文图2,研究窗口为2019年7月至2024年12月;从原PDF裁出,未改写图内内容。CC BY 4.0。[5]
论文发现,相关活动在2024年明显增加;大量疑似假Star用于推广短命的钓鱼或恶意软件仓库,其他用途包括AI/LLM、区块链、工具和教程等。对推广效果的分析显示,疑似刷星与后续真实关注的正向关系主要出现在不足两个月的短期,长期表现更差。这项观察研究不能证明刷星带来持续采用,更没有证明它带来融资或付费客户。[5]
刷星因而不只是“数字有点水分”。被包装的仓库可能让用户误判可信程度,进而下载或执行危险代码。CMU的研究介绍也强调了利用虚假热度传播恶意软件的风险。[6] 高Star可以提示值得检查,不能替代对来源、依赖和执行内容的检查。
GitHub使用政策明确禁止虚假互动、自动化刷星等排名滥用。[7] 正常介绍项目、邀请真实用户自愿收藏,与购买承诺数量的虚假互动,应当区分。真实教程帮助用户判断用途;刷星交易把“看起来受欢迎”本身当作交付。
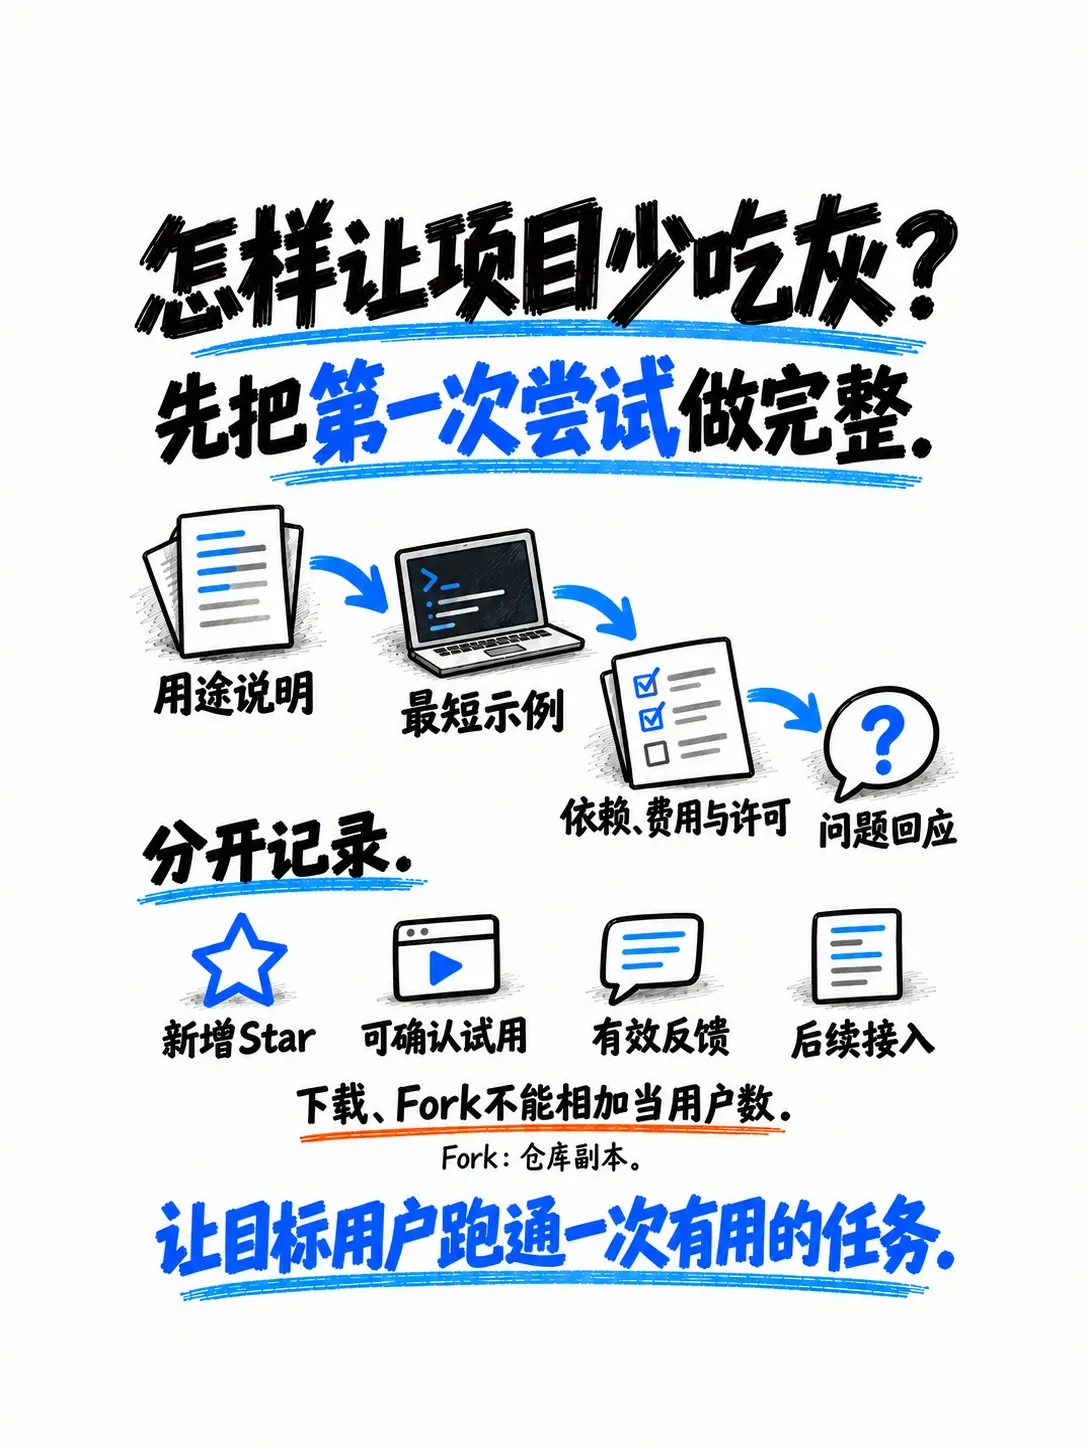
对项目经营者,刷星还有一个更直接的问题:数字上涨以后,采用障碍依然存在。文档不清楚、示例跑不通、依赖费用过高、问题无人处理,都不会因计数增加而消失。预算有限时,先让目标用户完成一次有用的尝试,比购买一条无法解释后续行为的曲线更值得投入。
五、从Star到采用:开源项目怎样接住关注
刷星改变了计数,真正使用项目的人仍要解决运行与接入问题。公开代码或模型权重,可以让关注者取得成果、检查条件并尝试复现;文档、许可与维护则决定这一步能否继续。开源为采用提供了机会,却不会自动带来更多Star或持续使用。
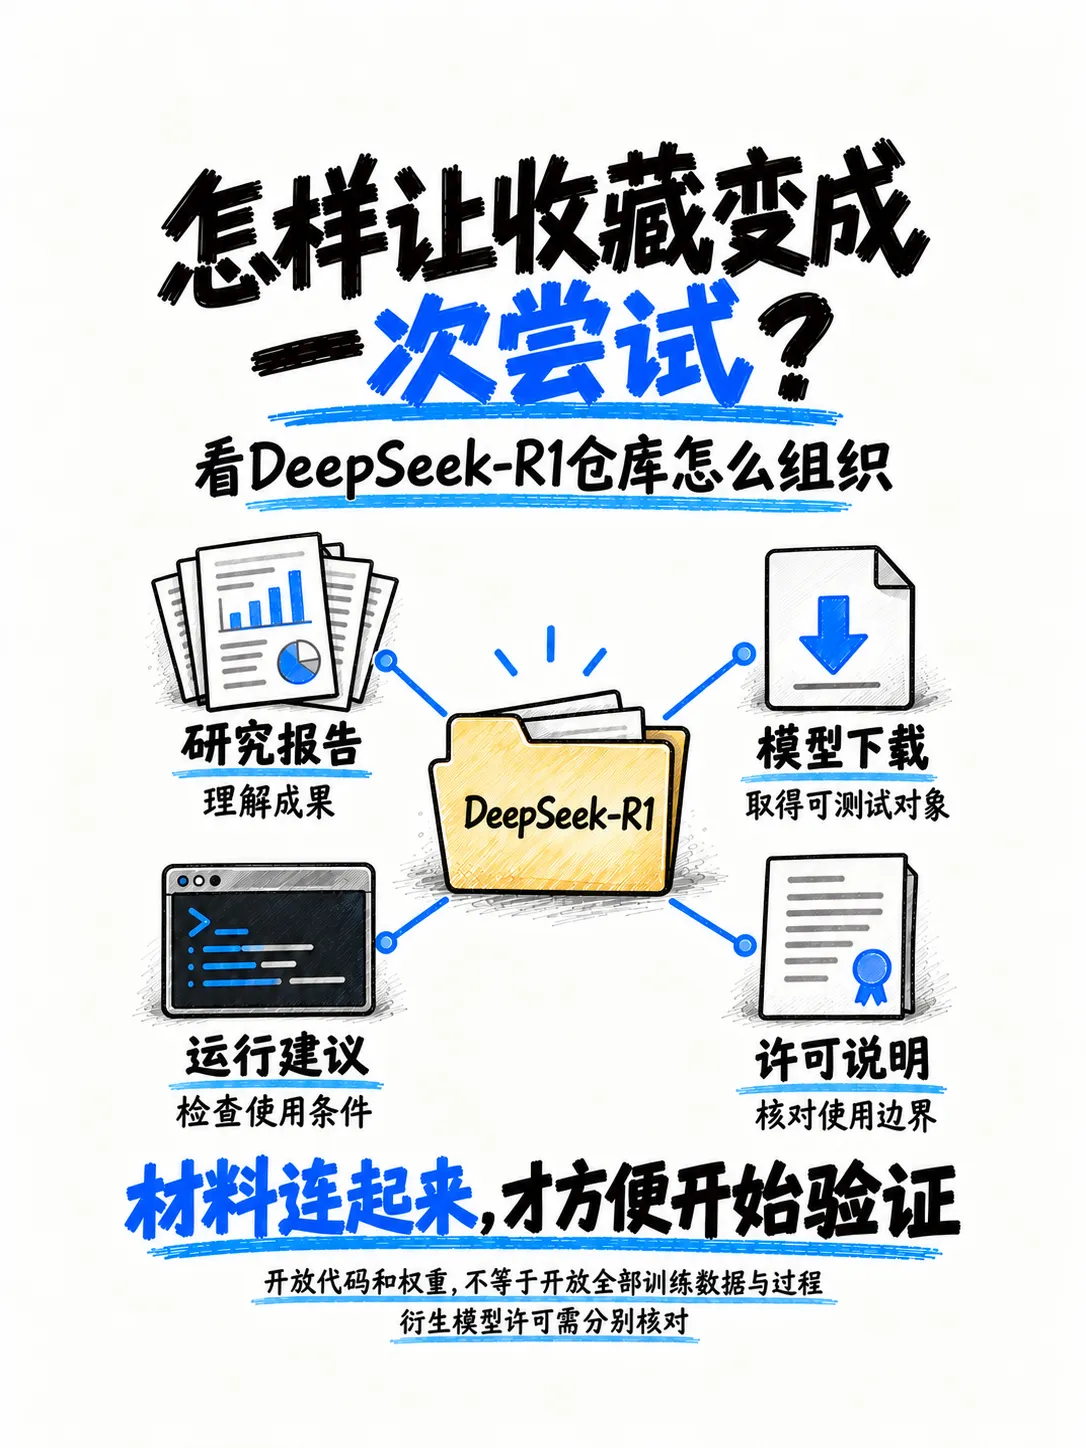
DeepSeek-R1的仓库展示了这种承接方式。2025年1月20日,DeepSeek发布R1,同时提供API访问,并宣布代码与模型权重采用MIT许可,允许商用和衍生开发。[8] 官方仓库将研究报告、权重下载、运行建议和不同规模的蒸馏模型连接起来。[9] 关注者可以在同一入口检查模型介绍、选择下载对象,并查找运行所需材料。这里开放的内容不等于全部训练数据与训练过程;Llama、Qwen衍生模型的原始许可也须分别检查。
对增长而言,这些材料给Star之后的行动提供了具体去处。研究者可以继续读报告,开发者可以下载并测试,集成方可以判断部署条件。仓库因此有机会成为教程、讨论和集成说明共同指向的出处。这是本书对采用条件的分析,现有资料并不能证明其中有多少使用由Star带来。
传播还可以沿第三方接入继续。2025年1月29日,微软宣布在Azure AI Foundry和GitHub提供R1;1月30日,AWS公布相应模型的部署入口。[10][11] 这些动作说明模型能够通过更多服务被取得,不能据此倒推接入由GitHub热度促成。用户在第三方平台运行模型,也未必产生DeepSeek的API收入。公开关注、生态采用与自营收入应分别观察。
这一区别也适用于其他项目。核心能力通过闭源服务交付,可以提供公开SDK和示例帮助接入;开放代码或权重,也可以另行提供收费托管。选择开放什么,应围绕目标用户的采用障碍和团队的交付能力,不必为了争取Star而扩大开放范围。
项目团队可以先把仓库中的第一次尝试做完整:README说清解决什么任务,给出最短运行示例,并标明模型或API依赖、费用、硬件和许可。发布新版本时,说明对谁有用、怎样复现变化;有人报告安装或兼容问题,再将修复补回文档与代码。这样,传播带来的人才有条件验证自己关心的用途。
每次发布保留时间、来源和版本,分别观察新增Star、能够确认的试用、有效反馈与后续接入。下载可能包含自动化,Fork可能只是备份,自部署也可能无法持续观测。只记录可靠取得的行为,不用关注数补齐未知的采用或收入。
Star可以让项目进入候选,仓库还需要帮助用户作出下一步判断。DeepSeek案例值得借鉴的,是让报告、可取得的模型和使用条件连接起来。对任何团队,涨星之后更值得追问的是:关注者能否开始,在哪里遇到障碍,以及是否把成果继续用进了自己的任务。